
GraphRAG vs. RAG stellt die primäre Wahl für Unternehmen dar, die verbessern möchten, wie ihre KI-Systeme Informationen abrufen und verarbeiten. Während die standardmäßige Retrieval-Augmented Generation (RAG) stark auf die Vektorsuche angewiesen ist, um ähnliche Dokumente zu finden, kombiniert GraphRAG die Vektorsuche mit Wissensgraphen, um spezifische Beziehungen zwischen Datenpunkten abzubilden. Dieser Ansatz ermöglicht es Systemen, komplexe Abfragen zu beantworten, bei denen Punkte über einen großen Datensatz hinweg verknüpft werden müssen, anstatt nur Schlüsselwörter oder semantische Ähnlichkeit in isolierten Textblöcken zu identifizieren.
Was ist der Kernunterschied zwischen RAG und GraphRAG?
Standard-RAG funktioniert, indem Text in numerische Vektoren umgewandelt wird. Wenn ein Benutzer eine Frage stellt, durchsucht das System diese Vektoren nach den relevantesten Dokumentensegmenten. Diese Methode funktioniert gut für spezifische, faktenbasierte Fragen, bei denen die Antwort an einem einzigen Ort existiert. Sie verfehlt jedoch oft das große Ganze, wenn eine Antwort das Verständnis der Verbindung zwischen unterschiedlichen Informationsteilen erfordert. Sie agiert wie ein Bibliothekar, der ein bestimmtes Buch findet, aber nicht bemerkt, wie die Charaktere in diesem Buch mit einem anderen Band in einem anderen Regal zusammenhängen.
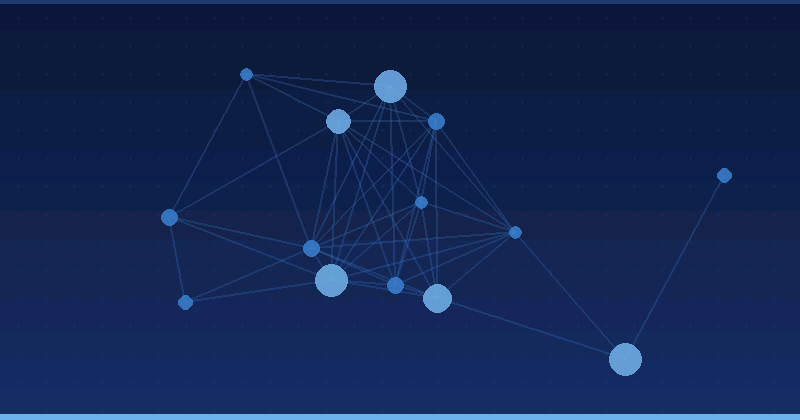
GraphRAG fügt diesem Prozess eine strukturierte Ebene hinzu, indem es einen Wissensgraphen erstellt. Ein Wissensgraph speichert Entitäten und die Beziehungen zwischen ihnen und schafft so ein Netzwerk von Fakten. Durch die Verknüpfung des Vektorabrufprozesses mit diesem Graphen kann das System Pfade zwischen verwandten Entitäten durchqueren. Wenn eine Abfrage nach den Auswirkungen einer bestimmten Lieferkettenunterbrechung auf mehrere regionale Niederlassungen fragt, kann GraphRAG alle betroffenen Entitäten identifizieren, da sie Knoten sind, die innerhalb derselben Graphenstruktur verbunden sind. Dies schafft eine viel höhere Dichte an kontextuellem Bewusstsein für das zugrunde liegende Modell.
Wann sollten Sie RAG für Ihre Daten wählen?
Die Wahl zwischen diesen beiden Ansätzen hängt weitgehend von Ihrer Datenstruktur und der Komplexität der Abfrage ab. RAG ist im Allgemeinen schneller zu implementieren und erfordert weniger Rechenaufwand. Wenn Ihr Unternehmen einfache, flache Dokumente wie Produkthandbücher, Standardrichtlinien-Updates oder grundlegende FAQs durchsuchen muss, liefert RAG oft ausreichende Ergebnisse bei minimalem Wartungsaufwand. Es vermeidet die Komplexität des Aufbaus und der Pflege eines Wissensgraphen, was es zu einem soliden Startpunkt für viele Organisationen macht.
Ein typisches Konto, das ein hohes Volumen an statischen Support-Tickets verwaltet, kann oft eine hohe Genauigkeit mit einer einfachen Vektorsuchimplementierung erreichen. Da die Daten in der Regel in sich geschlossen sind und keine Querverweise auf externe Entitäten erfordern, führt die zusätzliche Komplexität einer Graphenstruktur möglicherweise nicht zu einer proportionalen Steigerung der Abfrageleistung. Sie sollten bei Standard-RAG bleiben, wenn Ihr Hauptziel darin besteht, schnelle, dokumentspezifische Antworten zu liefern, ohne komplexe interne Beziehungen abbilden zu müssen.
Warum ist GraphRAG besser für komplexe Beziehungen?
GraphRAG wurde speziell für Szenarien entwickelt, in denen der Kontext in den Verknüpfungen zwischen Daten verborgen ist. In großen Unternehmen sind Informationen oft über Abteilungen, Projektprotokolle und historische Datenbanken hinweg fragmentiert. Standard-RAG gibt möglicherweise Fragmente dieser Berichte zurück, erkennt jedoch nicht, dass eine Entscheidung des Marketingteams im März die Budgetbeschränkungen des Engineering-Teams im Juli beeinflusste. Der Graphenansatz hält diese Entitäten verknüpft.
- Identifiziert indirekte Beziehungen, die die Vektorsuche möglicherweise ignoriert.
- Bietet eine klare Karte darüber, wie verschiedene Geschäftseinheiten oder Entitäten interagieren.
- Reduziert Halluzinationen, indem Antworten in expliziten Graphenverbindungen verankert werden.
- Ermöglicht das Schließen über breite Datensätze hinweg, die sich über Zeit oder Abteilungen erstrecken.
Wie unterscheidet sich der Implementierungsprozess?
Die Implementierung von RAG umfasst in erster Linie die Auswahl eines Einbettungsmodells und einer Vektordatenbank. Sie verarbeiten Ihre Dokumente, zerlegen sie in Chunks und speichern sie im Index. Der Workflow ist unkompliziert: einlesen, einbetten und abfragen. Dies ist ein übliches Muster für Teams, die innerhalb weniger Wochen ein KI-gestütztes Suchtool unter Verwendung der bestehenden Cloud-basierten Infrastruktur bereitstellen müssen.
GraphRAG erfordert eine zusätzliche Schicht Data Engineering. Sie müssen zunächst Entitäten und deren Beziehungen aus Ihrem Quellmaterial extrahieren. Dies beinhaltet die Definition einer Ontologie, die umreißt, welche Arten von Entitäten (z. B. Personen, Produkte, Standorte) und Beziehungen (z. B. verwaltet, produziert, befindet_sich_in) für Ihr Unternehmen wichtig sind. Diese Einrichtungsphase dauert länger, zahlt sich jedoch aus, wenn Ihre Abfragen mehrstufiges Schlussfolgern erfordern, das eine einfache Vektorsuche nicht zuverlässig ausführen kann.
Wie Alien Road GraphRAG-Lösungen anwendet
Bei Alien Road folgen wir einem spezifischen Prozess, wenn wir bewerten, ob ein Kunde von Standard-RAG zu GraphRAG wechseln muss. In einem typischen Engagement beginnen wir mit der Analyse der Abfrageprotokolle. Wenn wir eine hohe Rate an Fragen sehen, die die Synthese von Daten aus verschiedenen Dokumententypen erfordern, empfehlen wir einen graphenbasierten Ansatz. Wir beginnen mit dem Aufbau eines klein angelegten Wissensgraphen, der sich auf die kritischsten Geschäftsentitäten des Kunden konzentriert, um das Konzept vor der vollständigen Integration zu beweisen.
- Überprüfen Sie die Erfolgsquoten des aktuellen Datenabrufs, um Lücken im Kontext zu identifizieren.
- Bilden Sie wichtige Geschäftsentitäten und ihre Beziehungen ab, um die Graphenstruktur zu definieren.
- Erstellen Sie einen Pilotgraphen mit einer Teilmenge hochpreisiger interner Dokumentation.
- Führen Sie vergleichende Tests zwischen rein vektorbezogenen und graphenintegrierten Abfragen durch.
- Überwachen Sie die Genauigkeit der Syntheseergebnisse, um die Entitätsgewichtung anzupassen.
Was sind die häufigsten Herausforderungen bei GraphRAG?
Die größte Herausforderung bei GraphRAG ist die Pflege des Wissensgraphen. Wenn sich Ihre Geschäftsdaten ändern, muss der Graph aktualisiert werden, um neue Beziehungen widerzuspiegeln. Wenn Sie eine neue Produktlinie hinzufügen oder Ihre Organisationsstruktur ändern, muss Ihre Graphenextraktionslogik diese Verschiebungen berücksichtigen. Im Gegensatz zu Standard-RAG, bei dem Sie einfach neue Dokumente neu indizieren, beinhaltet die Graphenpflege die Sicherstellung, dass die neuen Informationen korrekt in das bestehende Netzwerk von Entitäten passen.
Ein weiteres Problem sind die Rechenkosten für die Graphentraverse zur Abfragezeit. Das Durchsuchen eines großen, komplexen Graphen ist ressourcenintensiver als das Durchführen einer Ähnlichkeitssuche in einer Vektordatenbank. Sie müssen Ihre Abrufpipeline optimieren, um sicherzustellen, dass das KI-Modell die relevanten Graphenpfade erhält, ohne hohe Latenzen auszulösen. Ein gängiges Muster ist die Kombination der lokalen Vektorsuche mit gezieltem Graphenabruf, um Geschwindigkeit und Genauigkeit auszugleichen.
Wo Sie diese Woche anfangen sollten
Beginnen Sie damit, Ihre komplexesten Abfragen zu identifizieren. Wählen Sie zehn Fragen von Ihren Benutzern aus, die Ihr aktuelles KI-Setup nicht korrekt beantworten kann, weil ihm der nötige Kontext fehlt. Stellen Sie fest, ob diese Fragen die Verbindung von Datenpunkten erfordern, die in separaten Silos gespeichert sind. Wenn die Antwort ja lautet, haben Sie einen starken Kandidaten für GraphRAG. Bilden Sie die an diesen Fragen beteiligten Entitäten ab und überlegen Sie, wie ein Graph sie miteinander verknüpfen könnte. Indem Sie sich auf diese spezifischen Anwendungsfälle konzentrieren, können Sie ein solides Fundament für intelligentere KI-Interaktionen schaffen, ohne Ihren gesamten Datensatz zu überengineern.
Weiterlesen: KI-Optimierung · KI-Optimierung