
GraphRAG vs RAG représente le choix principal pour les entreprises cherchant à améliorer la façon dont leurs systèmes d’IA récupèrent et traitent l’information. Alors que la Génération Augmentée par Récupération (RAG) standard repose fortement sur la recherche vectorielle pour trouver des documents similaires, GraphRAG associe la recherche vectorielle à des graphes de connaissances pour cartographier des relations spécifiques entre des points de données. Cette approche permet aux systèmes de répondre à des requêtes complexes qui nécessitent de relier les points à travers un vaste ensemble de données plutôt que de simplement identifier des mots-clés ou une similarité sémantique dans des blocs de texte isolés.
Quelle est la différence fondamentale entre RAG et GraphRAG ?
Le RAG standard fonctionne en convertissant le texte en vecteurs numériques. Lorsqu’un utilisateur pose une question, le système recherche dans ces vecteurs les segments de documents les plus pertinents. Cette méthode fonctionne bien pour des questions factuelles spécifiques où la réponse existe en un seul endroit. Cependant, elle passe souvent à côté de la vue d’ensemble lorsqu’une réponse nécessite de comprendre le lien entre des informations disparates. Il agit comme un bibliothécaire qui trouve un livre spécifique mais ne remarque pas comment les personnages de ce livre se rapportent à un autre volume sur une étagère différente.
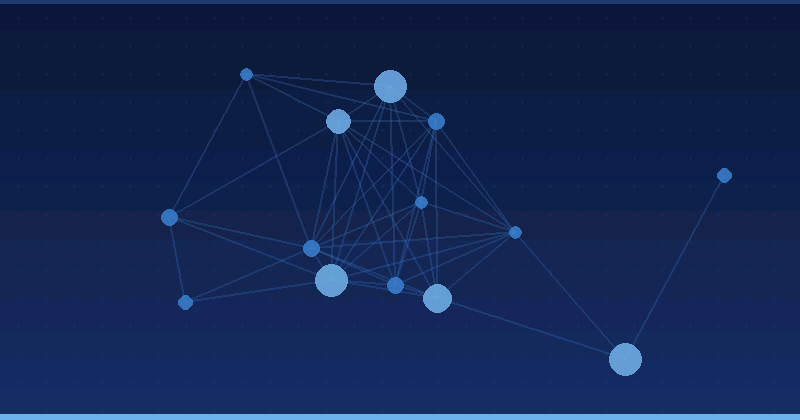
GraphRAG ajoute une couche structurée à ce processus en construisant un graphe de connaissances. Un graphe de connaissances stocke des entités et les relations entre elles, créant un réseau de faits. En liant le processus de récupération vectorielle à ce graphe, le système peut parcourir des chemins entre des entités apparentées. Si une requête interroge l’impact d’une perturbation spécifique de la chaîne d’approvisionnement sur plusieurs succursales régionales, GraphRAG peut identifier toutes les entités affectées car ce sont des nœuds connectés au sein de la même structure de graphe. Cela crée une densité de conscience contextuelle beaucoup plus élevée pour le modèle sous-jacent.
Quand devriez-vous choisir RAG pour vos données ?
Le choix entre ces deux approches dépend grandement de votre structure de données et de la complexité de vos requêtes. Le RAG est généralement plus rapide à mettre en œuvre et nécessite moins de ressources de calcul. Si votre entreprise a besoin de parcourir des documents simples et plats tels que des manuels de produits, des mises à jour de politiques standard ou des FAQ de base, le RAG fournit souvent des résultats suffisants avec un minimum de maintenance. Il évite la complexité de la construction et de la maintenance d’un graphe de connaissances, ce qui en fait un point de départ solide pour de nombreuses organisations.
Un compte typique gérant un volume élevé de tickets de support statiques peut souvent atteindre une haute précision avec une simple implémentation de recherche vectorielle. Étant donné que les données sont généralement autonomes et ne nécessitent pas de recoupement d’entités externes, la complexité accrue d’une structure de graphe peut ne pas générer une augmentation proportionnelle des performances des requêtes. Vous devez vous en tenir au RAG standard lorsque votre objectif principal est de fournir des réponses rapides et spécifiques aux documents sans avoir besoin de cartographier des relations internes complexes.
Pourquoi GraphRAG est-il meilleur pour les relations complexes ?
GraphRAG est spécifiquement conçu pour les scénarios où le contexte est caché dans les liens entre les données. Dans les grandes entreprises, l’information est souvent fragmentée entre les départements, les journaux de projets et les bases de données historiques. Le RAG standard peut renvoyer des fragments de ces rapports, mais il ne verra pas qu’une décision prise par l’équipe marketing en mars a influencé les contraintes budgétaires de l’équipe d’ingénierie en juillet. L’approche par graphe maintient ces entités liées.
- Identifie les relations indirectes que la recherche vectorielle pourrait ignorer.
- Fournit une carte claire de la façon dont les différentes unités commerciales ou entités interagissent.
- Réduit les hallucinations en ancrant les réponses dans des connexions de graphes explicites.
- Permet le raisonnement sur de larges ensembles de données qui s’étendent sur le temps ou les départements.
En quoi le processus de mise en œuvre diffère-t-il ?
La mise en œuvre de RAG implique principalement de choisir un modèle d’intégration et une base de données vectorielle. Vous traitez vos documents, les découpez en morceaux et les stockez dans l’index. Le flux de travail est simple : ingérer, intégrer et interroger. C’est un modèle courant pour les équipes qui ont besoin de déployer un outil de recherche assisté par IA en quelques semaines en utilisant une infrastructure cloud existante.
GraphRAG nécessite une couche supplémentaire d’ingénierie des données. Vous devez d’abord extraire les entités et leurs relations de votre matériel source. Cela implique de définir une ontologie qui décrit quels types d’entités (par exemple, personnes, produits, emplacements) et de relations (par exemple, gère, produit, situé_dans) comptent pour votre entreprise. Cette phase de configuration prend plus de temps, mais elle s’avère payante lorsque vos requêtes nécessitent un raisonnement en plusieurs étapes qu’une simple recherche vectorielle ne peut pas effectuer de manière fiable.
Comment Alien Road applique les solutions GraphRAG
Chez Alien Road, nous suivons un processus spécifique lors de l’évaluation de la nécessité pour un client de passer d’un RAG standard à GraphRAG. Dans le cadre d’une mission type, nous commençons par analyser les journaux de requêtes. Si nous constatons un taux élevé de questions nécessitant la synthèse de données provenant de différents types de documents, nous recommandons une approche basée sur les graphes. Nous commençons par construire un graphe de connaissances à petite échelle centré sur les entités commerciales les plus critiques du client pour prouver le concept avant l’intégration complète.
- Auditez les taux de réussite actuels de la récupération de données pour identifier les lacunes dans le contexte.
- Cartographiez les entités commerciales clés et leurs relations pour définir la structure du graphe.
- Construisez un graphe pilote en utilisant un sous-ensemble de documentation interne à haute valeur.
- Exécutez des tests comparatifs entre des requêtes vectorielles uniquement et des requêtes intégrées par graphe.
- Surveillez la précision des résultats de synthèse pour ajuster la pondération des entités.
Quels sont les défis courants avec GraphRAG ?
Le plus grand défi avec GraphRAG est la maintenance du graphe de connaissances. Au fur et à mesure que vos données professionnelles changent, le graphe doit être mis à jour pour refléter les nouvelles relations. Si vous ajoutez une nouvelle gamme de produits ou modifiez votre structure organisationnelle, votre logique d’extraction de graphe doit tenir compte de ces changements. Contrairement au RAG standard, où vous réindexez simplement de nouveaux documents, la maintenance des graphes implique de s’assurer que les nouvelles informations s’intègrent correctement dans le réseau existant d’entités.
Un autre problème est le coût de calcul du parcours de graphe au moment de la requête. La recherche dans un graphe grand et complexe est plus gourmande en ressources que l’exécution d’une recherche de similarité dans une base de données vectorielle. Vous devez optimiser votre pipeline de récupération pour vous assurer que le modèle d’IA reçoit les chemins de graphes pertinents sans déclencher une latence élevée. Un modèle courant consiste à combiner la recherche vectorielle locale avec une récupération de graphe ciblée pour équilibrer la vitesse et la précision.
Par où commencer cette semaine
Commencez par identifier vos requêtes les plus complexes. Sélectionnez dix questions de vos utilisateurs auxquelles votre configuration actuelle d’IA ne parvient pas à répondre correctement parce qu’elle manque du contexte nécessaire. Déterminez si ces questions nécessitent de relier des points de données stockés dans des silos séparés. Si la réponse est oui, vous avez un candidat solide pour GraphRAG. Cartographiez les entités impliquées dans ces questions et examinez comment un graphe pourrait les relier. En vous concentrant sur ces cas d’usage spécifiques, vous pouvez bâtir une base solide pour des interactions d’IA plus intelligentes sans sur-concevoir toute votre pile de données.
Continuer la lecture : Optimisation par IA · Optimisation par IA