JavaScript es una parte importante de la plataforma web porque proporciona muchas funciones que convierten la web en una plataforma de aplicaciones potente. Hacer que sus aplicaciones web basadas en JavaScript sean detectables a través de la Búsqueda de Google puede ayudarle a encontrar nuevos usuarios y volver a atraer a los existentes mientras buscan el contenido que proporciona su aplicación web. Si bien la Búsqueda de Google ejecuta JavaScript con una versión evergreen de Chromium, hay algunas cosas que puede optimizar.
Esta guía describe cómo la Búsqueda de Google procesa JavaScript y las mejores prácticas para mejorar las aplicaciones web de JavaScript para la Búsqueda de Google.
Cómo procesa Google JavaScript
Google procesa las aplicaciones web de JavaScript en tres fases principales:
- Rastreo
- Renderizado
- Indexación
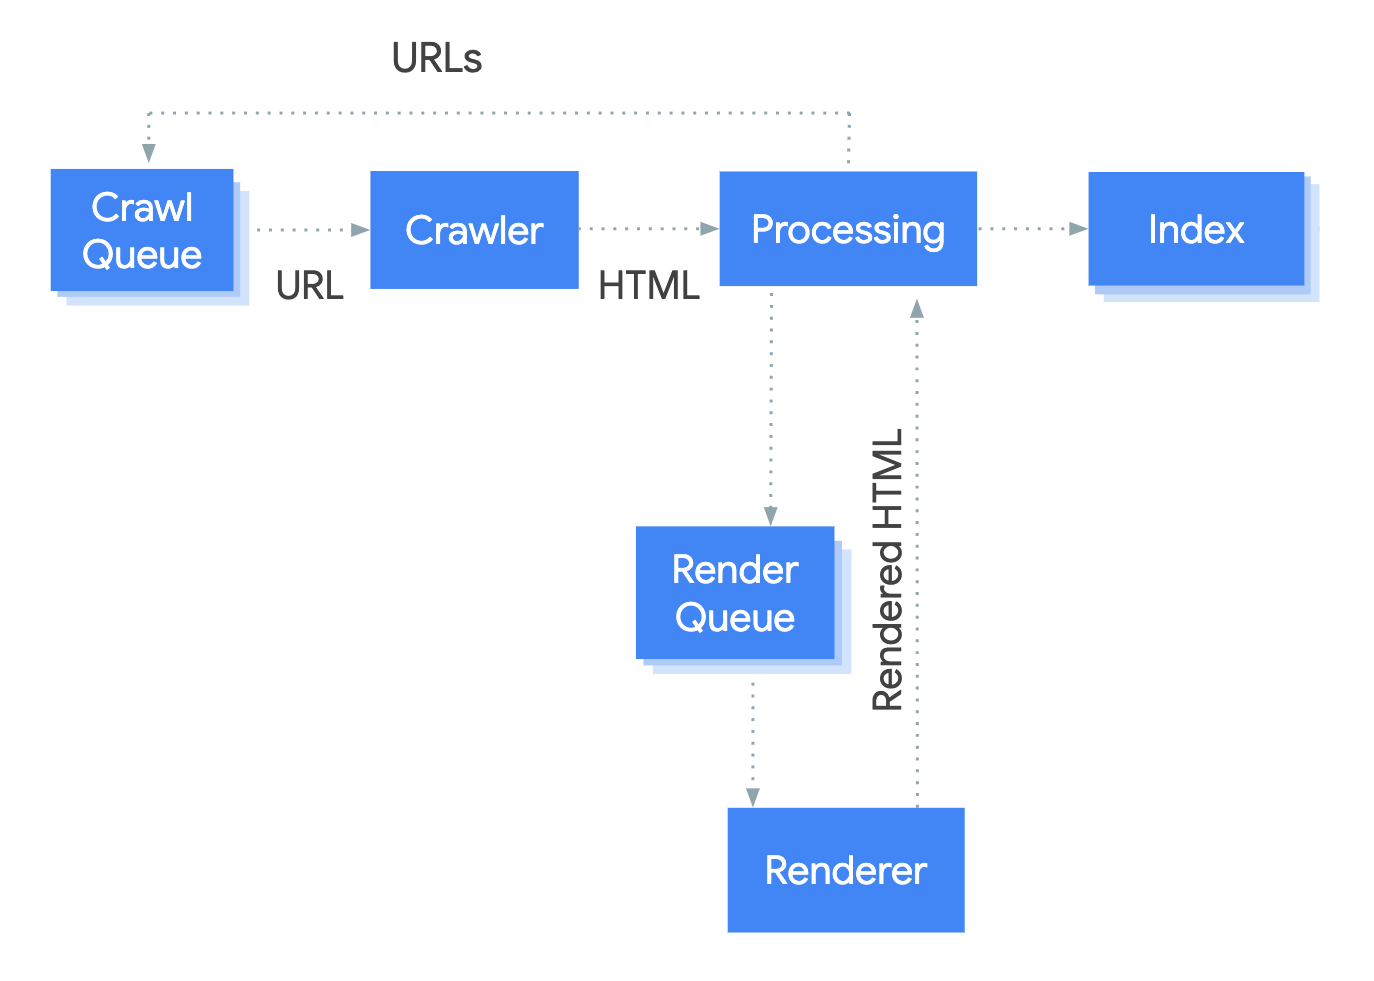
Googlebot pone en cola las páginas tanto para el rastreo como para el renderizado. No es inmediatamente obvio cuándo una página está esperando para ser rastreada y cuándo está esperando para ser renderizada. Cuando Googlebot obtiene una URL de la cola de rastreo realizando una solicitud HTTP, primero verifica si permite el rastreo. Googlebot lee el archivo robots.txt . Si marca la URL como no permitida, Googlebot omite realizar una solicitud HTTP a esta URL y omite la URL. La Búsqueda de Google no renderizará JavaScript de archivos bloqueados o en páginas bloqueadas.
Googlebot luego analiza la respuesta en busca de otras URL en el atributo href de los enlaces HTML y agrega las URL a la cola de rastreo. Para evitar el descubrimiento de enlaces, utilice el mecanismo nofollow ..
. Rastrear una URL y analizar la respuesta HTML funciona bien para sitios web clásicos o páginas renderizadas del lado del servidor donde el HTML en la respuesta HTTP contiene todo el contenido. Algunos sitios de JavaScript pueden usar el modelo de shell de aplicación donde el HTML inicial no contiene el contenido real y Google necesita ejecutar JavaScript antes de poder ver el contenido real de la página que genera JavaScript.
Googlebot pone en cola todas las páginas con un 200 código de estado HTTP para el renderizado, a menos que una metaetiqueta robots o un encabezado le indique a Google que no indexe la página. La página puede permanecer en esta cola durante unos segundos, pero puede llevar más tiempo. Una vez que los recursos de Google lo permiten, un Chromium sin cabeza renderiza la página y ejecuta el JavaScript. Googlebot analiza el HTML renderizado en busca de enlaces nuevamente y pone en cola las URL que encuentra para el rastreo. Google también utiliza el HTML renderizado para indexar la página.
Tenga en cuenta que el renderizado del lado del servidor o el prerenderizado sigue siendo una gran idea porque hace que su sitio web sea más rápido para los usuarios y los rastreadores, y no todos los bots pueden ejecutar JavaScript.
Describa su página con títulos y fragmentos únicos
Elementos <title> únicos y descriptivos y meta descripciones ayudan a los usuarios a identificar rápidamente el mejor resultado para su objetivo. Puede usar JavaScript para establecer o cambiar la meta descripción, así como el elemento <title> .
Establezca la URL canónica
La etiqueta de enlace rel=”canonical” ayuda a Google a encontrar la versión canónica de una página. Puede usar JavaScript para establecer la URL canónica, pero tenga en cuenta que no debe usar JavaScript para cambiar la URL canónica a algo diferente de la URL que especificó como URL canónica en el HTML original. La mejor manera de establecer la URL canónica es usar HTML, pero si tiene que usar JavaScript, asegúrese de establecer siempre la URL canónica con el mismo valor que el HTML original. Si no puede establecer la URL canónica en el HTML, puede usar JavaScript para establecer la URL canónica y omitirla del HTML original.
Escriba código compatible
Los navegadores ofrecen muchas API y JavaScript es un lenguaje en rápida evolución. Google tiene algunas limitaciones con respecto a qué API y funciones de JavaScript admite. Para asegurarse de que su código sea compatible con Google, siga nuestras.
pautas para solucionar problemas de JavaScript . Recomendamos usar servicio diferencial y polyfills
si detecta una API de navegador faltante que necesita. Dado que algunas funciones del navegador no se pueden completar con polyfills, le recomendamos que consulte la documentación de polyfills para conocer las posibles limitaciones.
Use códigos de estado HTTP significativos Googlebot utiliza códigos de estado HTTP
para averiguar si algo salió mal al rastrear la página. 404 Para decirle a Googlebot si una página no se puede rastrear o indexar, use un código de estado significativo, como un 401 para una página que no se pudo encontrar o un
código para páginas detrás de un inicio de sesión. Puede usar códigos de estado HTTP para decirle a Googlebot si una página se ha movido a una nueva URL, para que el índice se pueda actualizar en consecuencia. Aquí hay una lista de códigos de estado HTTP
y cómo afectan a la Búsqueda de Google. Evite errores soft 404
en aplicaciones de una sola página En las aplicaciones de una sola página renderizadas del lado del cliente, el enrutamiento a menudo se implementa como enrutamiento del lado del cliente. En este caso, usar códigos de estado HTTP significativos puede ser imposible o poco práctico. Para evitar errores soft 404 al usar renderizado y enrutamiento del lado del cliente, use una de las siguientes estrategias:
- Use una redirección de JavaScript a una URL para la cual el servidor responde con un
404Código de estado HTTP (por ejemplo,/not-found). - Añada un
<meta name="robots" content="noindex">a las páginas de error usando JavaScript.
Aquí tiene un código de ejemplo para el enfoque de redirección:
Aquí tiene un código de ejemplo para el enfoque de noindex etiqueta:
Use la History API en lugar de fragmentos
Google solo puede descubrir sus enlaces si son <a> elementos HTML con un href atributo.
Para aplicaciones de una sola página con enrutamiento del lado del cliente, use la History API para implementar el enrutamiento entre diferentes vistas de su aplicación web.
Para asegurarse de que Googlebot pueda analizar y extraer sus URL, no use fragmentos para cargar contenido de página diferente.
El siguiente ejemplo es una mala práctica, porque Googlebot no puede resolver las URL de manera confiable:
En su lugar, puede asegurarse de que sus URL sean accesibles para Googlebot implementando la History API:
Inyecte correctamente la rel="canonical" etiqueta de enlace
Aunque no recomendamos usar JavaScript para esto, es posible inyectar una rel="canonical" etiqueta de enlace con JavaScript.
La Búsqueda de Google recogerá la URL canónica inyectada al renderizar la página. Aquí hay un ejemplo para inyectar una rel="canonical" etiqueta de enlace con JavaScript:
Use robots meta etiquetas con cuidado
Puede evitar que Google indexe una página o siga enlaces a través de la robots meta etiqueta.
Por ejemplo, añadir la siguiente meta etiqueta en la parte superior de su página bloquea a Google para que no indexe la página:
Puede usar JavaScript para añadir una robots meta etiqueta a una página o cambiar su contenido.
El siguiente código de ejemplo muestra cómo cambiar la robots meta etiqueta con JavaScript para evitar la indexación de la página actual si una llamada a la API no devuelve contenido.
Use almacenamiento en caché de larga duración
Googlebot almacena en caché de forma agresiva para reducir las solicitudes de red y el uso de recursos. WRS puede ignorar los encabezados de caché. Esto puede llevar a que WRS utilice recursos de JavaScript o CSS obsoletos.
La huella digital del contenido evita este problema haciendo que una huella digital del contenido sea parte del nombre del archivo, como main.2bb85551.js.
La huella digital depende del contenido del archivo, por lo que las actualizaciones generan un nombre de archivo diferente cada vez.
Consulte la guía de web.dev sobre estrategias de almacenamiento en caché de larga duración para aprender más.
Use datos estructurados
Cuando use datos estructurados en sus páginas, puede usar JavaScript para generar el JSON-LD requerido e inyectarlo en la página. Asegúrese de probar su implementación para evitar problemas.
Siga las mejores prácticas para componentes web
Google admite componentes web. Cuando Google renderiza una página, aplana el shadow DOM y el light DOM contenido. Esto significa que Google solo puede ver el contenido que es visible en el HTML renderizado. Para asegurarse de que Google pueda seguir viendo su contenido después de que se renderice, utilice la Rich Results Test o la URL Inspection Tool y observe el HTML renderizado.
Si el contenido no es visible en el HTML renderizado, Google no podrá indexarlo.
El siguiente ejemplo crea un componente web que muestra su contenido light DOM dentro de su shadow DOM. Una forma de asegurarse de que tanto el contenido light DOM como el shadow DOM se muestren en el HTML renderizado es utilizar un Slot elemento.
Después de renderizar, Google puede indexar este contenido:
Corrija las imágenes y el contenido de carga diferida (lazy-loading)
Las imágenes pueden ser bastante costosas en cuanto a ancho de banda y rendimiento. Una buena estrategia es utilizar la carga diferida para cargar las imágenes solo cuando el usuario esté a punto de verlas. Para asegurarse de implementar la carga diferida de una manera compatible con la búsqueda, siga nuestras directrices de carga diferida.
Cómo lo aplicamos
JavaScript SEO problems are rendering problems. We test what Googlebot receives rather than what the browser shows, because the two differ on most modern client-side frameworks.
Servicios relacionados