JavaScript — важная часть веб-платформы, поскольку он предоставляет множество функций, превращающих веб в мощную платформу для приложений. Сделав свои веб-приложения на JavaScript доступными для Google Search, вы сможете находить новых пользователей и повторно привлекать существующих, когда они ищут контент, предоставляемый вашим веб-приложением. Хотя Google Search выполняет JavaScript с помощью постоянно обновляемой версии Chromium, есть несколько вещей, которые можно оптимизировать.
В этом руководстве описывается, как Google Search обрабатывает JavaScript, и приводятся лучшие практики по улучшению JavaScript-веб-приложений для Google Search.
Как Google обрабатывает JavaScript
Google обрабатывает JavaScript-веб-приложения в три основных этапа:
- Сканирование (Crawling)
- Рендеринг
- Индексирование
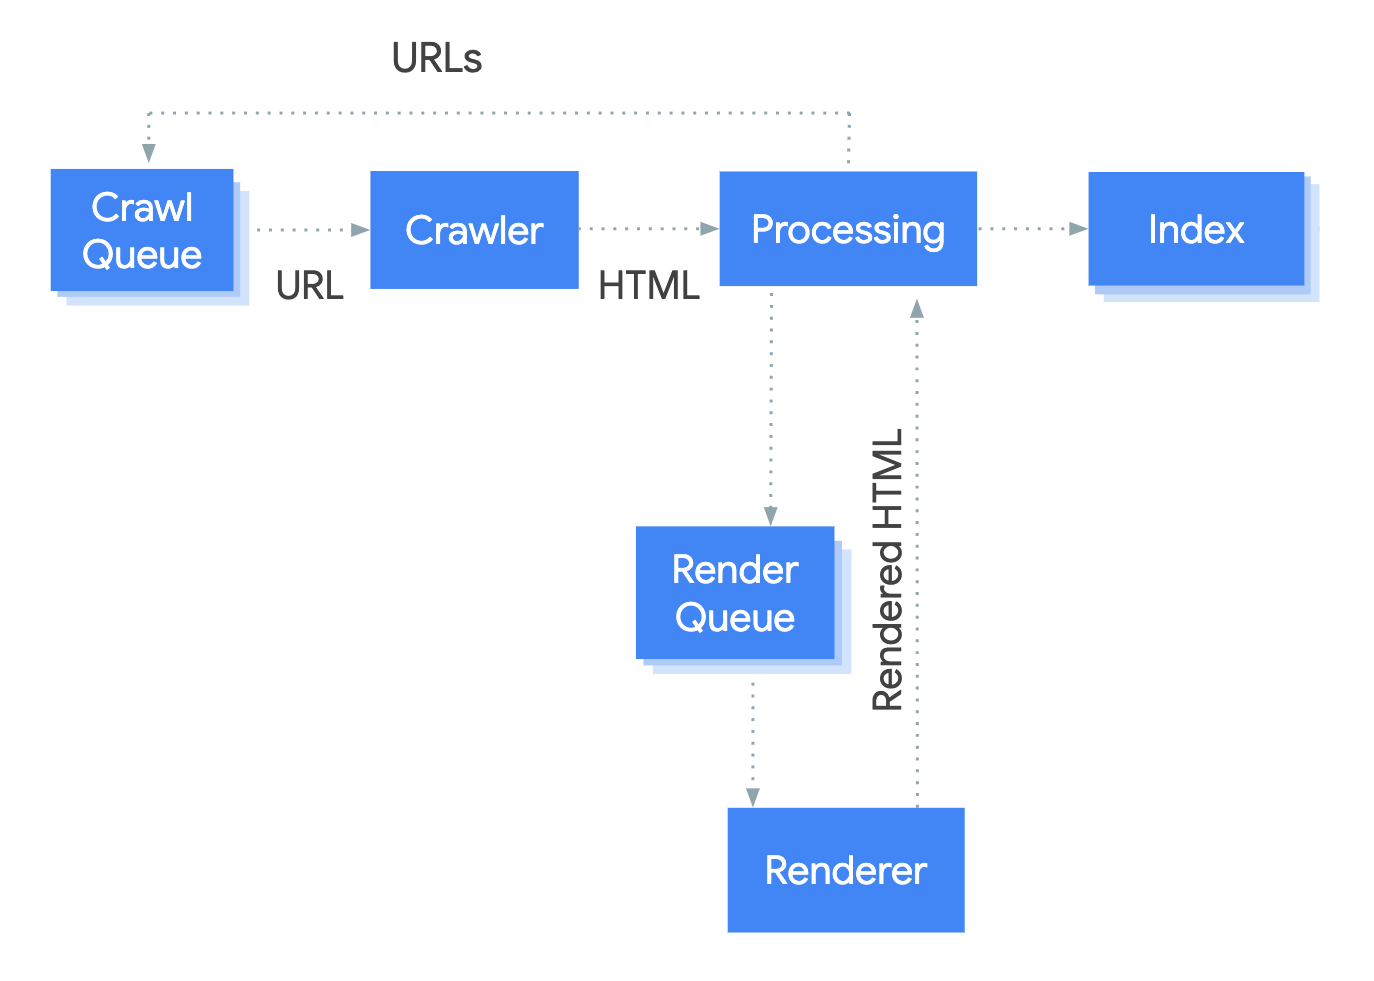
Googlebot ставит страницы в очередь как на сканирование, так и на рендеринг. Не сразу понятно, когда страница ожидает сканирования, а когда — рендеринга. Когда Googlebot извлекает URL из очереди сканирования, выполняя HTTP-запрос, он сначала проверяет, разрешено ли сканирование. Googlebot читает файл robots.txt . Если он помечает URL как запрещенный, Googlebot пропускает выполнение HTTP-запроса к этому URL и пропускает сам URL. Google Search не будет выполнять рендеринг JavaScript из заблокированных файлов или на заблокированных страницах.
Затем Googlebot анализирует ответ на наличие других URL в атрибуте href HTML-ссылок и добавляет эти URL в очередь сканирования. Чтобы предотвратить обнаружение ссылок, используйте механизм nofollow ..
. Сканирование URL и анализ HTML-ответа хорошо работают для классических веб-сайтов или страниц, отрендеренных на стороне сервера, где HTML в HTTP-ответе содержит весь контент. Некоторые сайты на JavaScript могут использовать модель приложения-оболочки (app shell model) , где начальный HTML не содержит фактического контента, и Google должен выполнить JavaScript, прежде чем сможет увидеть фактический контент страницы, который генерирует JavaScript.
Googlebot ставит все страницы с 200 HTTP-кодом состояния в очередь на рендеринг, если только метатег robots или заголовок не указывает Google не индексировать страницу. Страница может оставаться в этой очереди несколько секунд, но это может занять и больше времени. Как только ресурсы Google позволяют, «безголовый» (headless) Chromium рендерит страницу и выполняет JavaScript. Googlebot снова анализирует отрендеренный HTML на наличие ссылок и ставит найденные URL в очередь на сканирование. Google также использует отрендеренный HTML для индексации страницы.
Помните, что рендеринг на стороне сервера или предварительный рендеринг по-прежнему остаются отличной идеей, так как это делает ваш веб-сайт быстрее для пользователей и поисковых роботов, а не все боты могут выполнять JavaScript.
Описывайте свою страницу уникальными заголовками и сниппетами
Уникальные, описательные элементы <title> и метаописания помогают пользователям быстро определить лучший результат для их цели. Вы можете использовать JavaScript для установки или изменения метаописания, а также элемента <title> .
Установите канонический URL
Браузеры предлагают множество API, а JavaScript — быстро развивающийся язык. У Google есть некоторые ограничения относительно того, какие API и функции JavaScript он поддерживает. Чтобы убедиться, что ваш код
совместим с Google, следуйте нашим рекомендациям по устранению проблем с JavaScript.
. Мы рекомендуем использовать дифференциальную подачу (differential serving) и полифиллы , если вы обнаружили отсутствие необходимого API браузера. Поскольку некоторые функции браузера нельзя реализовать с помощью полифиллов, мы рекомендуем вам проверить документацию по полифиллам на наличие потенциальных ограничений.
Используйте значимые HTTP-коды состояния
Googlebot использует HTTP-коды состояния , чтобы узнать, не произошло ли что-то не так при сканировании страницы.
Чтобы сообщить Googlebot, что страницу нельзя сканировать или индексировать, используйте значимый код состояния, например 404 для страницы, которую не удалось найти, или 401 код для страниц, закрытых логином. Вы можете использовать HTTP-коды состояния, чтобы сообщить Googlebot, что страница перемещена на новый URL, чтобы индекс мог быть соответствующим образом обновлен.
Вот список HTTP-кодов состояния и то, как они влияют на Google Search.
Избегайте ошибок soft 404 в одностраничных приложениях
В одностраничных приложениях, отрендеренных на стороне клиента, маршрутизация часто реализуется как маршрутизация на стороне клиента. В этом случае использование значимых HTTP-кодов состояния может быть невозможным или непрактичным. Чтобы избежать ошибок soft 404 при использовании рендеринга и маршрутизации на стороне клиента, используйте одну из следующих стратегий: Используйте
- JavaScript-перенаправление на URL, для которого сервер отвечает с кодом
404HTTP-код состояния (например,/not-found). - Добавьте
<meta name="robots" content="noindex">на страницы ошибок с помощью JavaScript.
Вот пример кода для подхода с перенаправлением:
Вот пример кода для подхода с noindex тегом:
Используйте History API вместо фрагментов
Google может обнаружить ваши ссылки, только если они являются <a> HTML-элементами с href атрибутом.
Для одностраничных приложений с клиентской маршрутизацией используйте History API для реализации маршрутизации между различными представлениями вашего веб-приложения.
Чтобы убедиться, что Googlebot может анализировать и извлекать ваши URL-адреса, не используйте фрагменты для загрузки различного контента страницы.
Следующий пример является плохой практикой, так как Googlebot не может надежно разрешить URL-адреса:
Вместо этого вы можете убедиться, что ваши URL-адреса доступны для Googlebot, реализовав History API:
Правильно внедрите rel="canonical" тег ссылки
Хотя мы не рекомендуем использовать для этого JavaScript, можно внедрить rel="canonical" тег ссылки с помощью JavaScript.
Поиск Google подхватит внедренный канонический URL при рендеринге страницы. Вот пример внедрения rel="canonical" тега ссылки с помощью JavaScript:
Используйте robots meta теги осторожно
Вы можете запретить Google индексировать страницу или переходить по ссылкам с помощью robots meta тега.
Например, добавление следующего meta тега в начало вашей страницы блокирует индексацию страницы Google:
Вы можете использовать JavaScript, чтобы добавить robots meta тег на страницу или изменить его содержимое.
Следующий пример кода показывает, как изменить robots meta тег с помощью JavaScript, чтобы предотвратить индексацию текущей страницы, если вызов API не возвращает контент.
Используйте долгосрочное кэширование
Googlebot агрессивно кэширует, чтобы уменьшить количество сетевых запросов и использование ресурсов. WRS может игнорировать заголовки кэширования. Это может привести к тому, что WRS будет использовать устаревшие ресурсы JavaScript или CSS.
Отпечаток контента (content fingerprinting) позволяет избежать этой проблемы, делая отпечаток контента частью имени файла, например main.2bb85551.js.
Отпечаток зависит от содержимого файла, поэтому обновления каждый раз генерируют другое имя файла.
Ознакомьтесь с руководством web.dev по стратегиям долгосрочного кэширования чтобы узнать больше.
Используйте структурированные данные
При использовании структурированных данных на ваших страницах вы можете использовать JavaScript для генерации необходимого JSON-LD и внедрения его на страницу. Убедитесь, что вы протестировали свою реализацию чтобы избежать проблем.
Следуйте лучшим практикам для веб-компонентов
Google поддерживает веб-компоненты. Когда Google рендерит страницу, он сглаживает shadow DOM и light DOM контент. Это означает, что Google может видеть только тот контент, который виден в отрендеренном HTML. Чтобы убедиться, что Google по-прежнему может видеть ваш контент после его рендеринга, используйте Rich Results Test или URL Inspection Tool и посмотрите на отрендеренный HTML.
Если контент не виден в отрендеренном HTML, Google не сможет его проиндексировать.
В следующем примере создается веб-компонент, который отображает свой контент light DOM внутри своего shadow DOM. Один из способов убедиться, что контент как light DOM, так и shadow DOM отображается в отрендеренном HTML, — это использовать элемент Slot .
После рендеринга Google может проиндексировать этот контент:
Исправьте изображения и контент с отложенной загрузкой (lazy-loading)
Изображения могут быть довольно затратными с точки зрения пропускной способности и производительности. Хорошая стратегия — использовать отложенную загрузку, чтобы загружать изображения только тогда, когда пользователь собирается их увидеть. Чтобы убедиться, что вы внедряете отложенную загрузку удобным для поиска способом, следуйте нашим рекомендациям по отложенной загрузке.
Как мы это применяем
JavaScript SEO problems are rendering problems. We test what Googlebot receives rather than what the browser shows, because the two differ on most modern client-side frameworks.
Связанные услуги