Jeudi 1er septembre 2011
Notre mission est d’organiser l’information à l’échelle mondiale et de la rendre universellement accessible et utile. Au cours de cette quête ambitieuse, nous rencontrons parfois des fichiers non HTML tels que des PDF, des feuilles de calcul et des présentations. Nos algorithmes ne laissent pas les différents types de fichiers les ralentir ; nous travaillons dur pour extraire le contenu pertinent et l’indexer de manière appropriée pour nos résultats de recherche. Mais comment indexons-nous réellement ces types de fichiers et, puisqu’ils diffèrent souvent beaucoup du HTML standard, quelles directives s’appliquent à ces fichiers ? Que se passe-t-il si un webmaster ne souhaite pas que nous les indexions ?
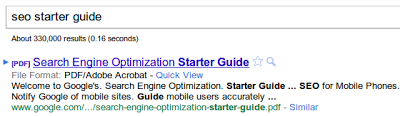
Google
a commencé à indexer des fichiers PDF en 2001
et possède actuellement
des centaines de millions de fichiers PDF indexés. Nous avons rassemblé les questions les plus fréquemment posées sur l’indexation des PDF ; voici les réponses :
Q : Google peut-il indexer n’importe quel type de fichier PDF ?
R : En général, nous pouvons indexer le contenu textuel (rédigé dans n’importe quelle langue) de fichiers PDF utilisant divers types d’encodage de caractères, à condition qu’ils ne soient pas protégés par mot de passe ou cryptés. Si le texte est incorporé sous forme d’images, nous pouvons traiter les images avec des algorithmes
OCR
pour extraire le texte. La règle générale est que si vous pouvez copier et coller le texte d’un document PDF dans un document texte standard, nous devrions être capables d’indexer ce texte.
Q : Que se passe-t-il avec les images dans les fichiers PDF ?
R : Actuellement, les images ne sont pas indexées. Pour que nous puissions indexer vos images, vous devez créer des pages HTML pour celles-ci. Pour augmenter la probabilité que nous renvoyions vos images dans nos résultats de recherche, veuillez lire les
Google Images best practices.
Q : Comment les liens sont-ils traités dans les documents PDF ?
R : En général, les liens dans les fichiers PDF sont traités de la même manière que les liens en HTML : ils peuvent transmettre le PageRank et d’autres signaux d’indexation, et nous pouvons les suivre après avoir exploré le fichier PDF. Il n’est actuellement pas possible d’utiliser des liens
nofollow
dans un document PDF.
Q : Comment puis-je empêcher mes fichiers PDF d’apparaître dans les résultats de recherche, ou s’ils y sont déjà, comment puis-je les supprimer ?
R : Le moyen le plus simple d’empêcher les documents PDF d’apparaître dans les résultats de recherche est d’ajouter une
X-Robots-Tag: noindex dans l’en-tête HTTP utilisé pour diffuser le fichier. S’ils sont déjà indexés, ils disparaîtront avec le temps si vous utilisez la balise X-Robot-Tag avec la règle
noindex . Pour des suppressions plus rapides, vous pouvez utiliser l’outil
URL removal tool
dans Google Webmaster Tools.
Q : Les fichiers PDF peuvent-ils se classer haut dans les résultats de recherche ?
R : Bien sûr ! Ils se classeront généralement de la même manière que les autres pages Web. Par exemple, au moment de cette publication,
mortgage market review,
irs form 2011, ou
paracetamol expert report
renvoient tous des documents PDF qui parviennent à se classer haut dans nos résultats de recherche, grâce à leur contenu et à la manière dont ils sont intégrés et liés à partir d’autres pages Web.
Q : Est-ce considéré comme du contenu dupliqué si j’ai une copie de mes pages à la fois en HTML et en PDF ?
R : Dans la mesure du possible, nous vous recommandons de diffuser une seule copie de votre contenu. Si cela n’est pas possible, assurez-vous d’indiquer votre version préférée en incluant, par exemple, l’URL préférée dans votre sitemap ou en spécifiant la version canonique dans le HTML ou dans les
HTTP headers
de la ressource PDF. Pour plus de conseils, lisez notre article du Centre d’aide sur
canonicalization.
.
Q : Comment puis-je influencer le titre affiché dans les résultats de recherche pour mon document PDF ?
R : Nous utilisons deux éléments principaux pour déterminer le titre affiché : les métadonnées de titre dans le fichier et le texte d’ancrage des liens pointant vers le fichier PDF. Pour donner à nos algorithmes un signal fort concernant le titre approprié à utiliser, nous recommandons de mettre à jour les deux.
Si vous souhaitez en savoir plus, regardez la vidéo de Matt Cutts surPDF files’ optimization for search
, et visitez notre
Help Center
pour obtenir des informations sur les types de contenu que nous sommes en mesure d’indexer. Si vous avez des commentaires ou des suggestions, veuillez nous le faire savoir dans le.
Comment nous l'appliquons
We archive Search Central announcements because client questions often trace back to a change that was announced years ago. Reading the original is faster than reconstructing it from second-hand summaries.
Services associés