Четверг, 1 сентября 2011 г.
Наша миссия — организовать информацию во всем мире и сделать ее общедоступной и полезной. В ходе этой амбициозной задачи мы иногда сталкиваемся с не-HTML файлами, такими как PDF, электронные таблицы и презентации. Наши алгоритмы не позволяют разным типам файлов замедлять их работу; мы упорно работаем над извлечением релевантного контента и его правильной индексацией для результатов поиска. Но как именно мы индексируем эти типы файлов и, поскольку они часто сильно отличаются от стандартного HTML, какие правила к ним применяются? Что делать, если веб-мастер не хочет, чтобы мы их индексировали?
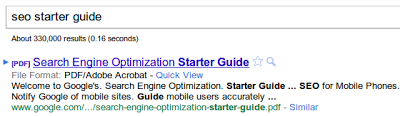
Google
впервые начал индексировать PDF-файлы в 2001 году
и в настоящее время имеет
сотни миллионов проиндексированных PDF-файлов. Мы собрали самые часто задаваемые вопросы об индексировании PDF; вот ответы на них:
В: Может ли Google индексировать любой тип PDF-файла?
О: Как правило, мы можем индексировать текстовый контент (написанный на любом языке) из PDF-файлов, использующих различные виды кодировок символов, при условии, что они не защищены паролем и не зашифрованы. Если текст встроен в виде изображений, мы можем обработать изображения с помощью алгоритмов
OCR
для извлечения текста. Общее правило гласит: если вы можете скопировать и вставить текст из PDF-документа в стандартный текстовый документ, мы должны иметь возможность проиндексировать этот текст.
В: Что происходит с изображениями в PDF-файлах?
О: В настоящее время изображения не индексируются. Чтобы мы могли проиндексировать ваши изображения, вам следует создать для них HTML-страницы. Чтобы увеличить вероятность показа ваших изображений в наших результатах поиска, пожалуйста, ознакомьтесь с материалом
Google Images best practices.
В: Как обрабатываются ссылки в PDF-документах?
О: Как правило, ссылки в PDF-файлах обрабатываются аналогично ссылкам в HTML: они могут передавать PageRank и другие сигналы индексирования, и мы можем переходить по ним после сканирования PDF-файла. В настоящее время использование ссылок
nofollow
внутри PDF-документа невозможно.
В: Как запретить моим PDF-файлам появляться в результатах поиска или, если они уже там, как их удалить?
О: Самый простой способ запретить PDF-документам появляться в результатах поиска — добавить тег
X-Robots-Tag: noindex в заголовок HTTP, используемый для передачи файла. Если они уже проиндексированы, они со временем исчезнут, если вы используете X-Robot-Tag с правилом
noindex . Для более быстрого удаления вы можете использовать
URL removal tool
в инструменте Google Webmaster Tools.
В: Могут ли PDF-файлы занимать высокие позиции в результатах поиска?
О: Конечно! Как правило, они ранжируются аналогично другим веб-страницам. Например, на момент публикации этой статьи
mortgage market review,
irs form 2011, или
paracetamol expert report
— все они возвращают PDF-документы, которым удается занимать высокие позиции в наших результатах поиска благодаря их содержимому, а также способу их внедрения и ссылок с других веб-страниц.
В: Считается ли дублированным контентом наличие копии моих страниц как в формате HTML, так и в формате PDF?
О: По возможности мы рекомендуем публиковать только одну копию вашего контента. Если это невозможно, обязательно укажите предпочитаемую версию, например, включив предпочитаемый URL в карту сайта (sitemap) или указав каноническую версию в HTML или в
HTTP headers
ресурса PDF. Дополнительные советы читайте в статье нашего Справочного центра, посвященной
canonicalization.
.
В: Как я могу повлиять на заголовок, отображаемый в результатах поиска для моего PDF-документа?
О: Мы используем два основных элемента для определения отображаемого заголовка: метаданные заголовка внутри файла и анкорный текст ссылок, указывающих на PDF-файл. Чтобы дать нашим алгоритмам четкий сигнал о правильном заголовке, мы рекомендуем обновить оба элемента.
Если вы хотите узнать больше, посмотрите видео Мэтта Каттса оPDF files’ optimization for search
, и посетите наш
Help Center
для получения информации о типах контента, которые мы можем индексировать. Если у вас есть отзывы или предложения, пожалуйста, сообщите нам об этом на.
Как мы это применяем
We archive Search Central announcements because client questions often trace back to a change that was announced years ago. Reading the original is faster than reconstructing it from second-hand summaries.
Связанные услуги