Среда, 25 апреля 2012 г.
Творчество является важным аспектом нашей жизни и может обогатить практически все, что мы делаем. Допустим, я хочу приготовить своему коллеге чашку красивого кофе, но мои творческие батарейки разряжены; это был бы (и является!) один из тех моментов, когда я ищу вдохновение на
Картинки Google.

Изображения, которые вы видите в наших результатах поиска, поступают от издателей самого разного масштаба — блогеров, СМИ, фотобанков, — которые встроили эти изображения в свои HTML-страницы. Google может индексировать типы изображений в форматах BMP, GIF, JPEG, PNG и WebP, а также SVG.
Но как Google узнает, что на изображениях изображен кофе, а не чай? Когда наши алгоритмы индексируют изображения, они изучают текстовый контент на странице, где было найдено изображение, чтобы узнать о нем больше. Мы также смотрим на заголовок и основной текст страницы; кроме того, мы можем получить дополнительную информацию из имени файла изображения, анкорного текста, указывающего на него, и егоальтернативного текста;” мы можем использовать компьютерное зрение, чтобы узнать больше об изображении, а также использовать подпись, указанную в
файле Sitemap изображений , если этот текст также присутствует на странице.
Чтобы помочь нам проиндексировать ваши изображения, убедитесь, что:
- мы можем сканировать как HTML-страницу, в которую встроено изображение, так и само изображение;
- изображение представлено в одном из поддерживаемых нами форматов: BMP, GIF, JPEG, PNG, WebP или SVG.
Кроме того, мы рекомендуем:
- чтобы имя файла изображения было связано с его содержимым;
- чтобы атрибут alt изображения описывал его понятным для людей образом;
- и, наконец, полезно, чтобы текстовое содержимое HTML-страницы, а также текст рядом с изображением были связаны с изображением.
А теперь несколько ответов на вопросы, которые мы часто слышали:
Q: Почему я иногда вижу, что Googlebot сканирует мои изображения, а не Googlebot-Image?
A: Как правило, это происходит, когда неясно, приведет ли URL-адрес к изображению, поэтому сначала мы сканируем URL-адрес с помощью Googlebot. Если мы обнаруживаем, что URL-адрес ведет к изображению, мы обычно возвращаемся к нему с помощью Googlebot-Image. Из-за этого обычно рекомендуется разрешать сканирование ваших изображений и страниц как для Googlebot, так и для Googlebot-Image.
Q: Правда ли, что для изображений существует максимальный размер файла?
A: Мы с радостью индексируем изображения любого размера; ограничений на размер файла нет.
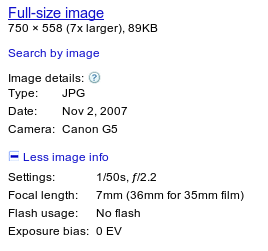
Q: Что происходит с метаданными EXIF, XMP и другими данными, которые содержат мои изображения?
A: Мы можем использовать любую найденную информацию, чтобы помочь нашим пользователям быстрее находить то, что они ищут. Кроме того, такая информация, как данные EXIF, может отображаться на правой боковой панели промежуточной страницы, которая появляется при клике на изображение.
Q: Стоит ли действительно отправлять Sitemap изображений? Каковы преимущества?
A: Да! Файлы Sitemap изображений
помогают нам узнать о ваших новых изображениях, а также понять, чему они посвящены.
Q: Я использую CDN для размещения своих изображений; как я все равно могу использовать Sitemap изображений?
A:
Междоменные ограничения
применяются только к тегу <loc> в файлах Sitemap. В файлах Sitemap изображений тегу
<image:loc> разрешено указывать на URL-адрес в другом домене, поэтому использование CDN для ваших изображений допустимо. Мы также рекомендуем подтвердить доменное имя CDN в Webmaster Tools, чтобы мы могли информировать вас о любых обнаруженных ошибках сканирования.
Q: Является ли проблемой, если мои изображения можно найти на нескольких доменах или поддоменах, принадлежащих мне, например, на CDN или связанных сайтах?
A: Как правило, лучшей практикой является наличие только одной копии контента любого типа. Если вы дублируете свои изображения на нескольких хостах, наши алгоритмы могут выбрать одну копию в качестве канонической копии изображения, что может не совпадать с вашей предпочтительной версией. Это также может привести к более медленному сканированию и индексированию ваших изображений.
Q: Иногда мы замечаем, что первоисточник изображения ранжируется ниже других источников; почему так происходит?
A: Имейте в виду, что при определении контекста изображения мы используем текстовое содержимое страницы. Например, если первоисточник — это страница из галереи изображений с очень небольшим количеством текста, может случиться так, что для показа в поиске будет выбрана страница с большим текстовым контекстом. Если вы считаете, что обнаружили очень плохие результаты поиска по конкретному запросу, вы можете использовать ссылку для отправки отзывов под результатами поиска или поделиться своим примером в нашем
Форуме справки для веб-мастеров.
SafeSearch
Наши алгоритмы используют самые разные сигналы, чтобы решить, следует ли исключать изображение (или всю страницу, если речь идет о веб-поиске) из результатов, когда у пользователя включен фильтр SafeSearch. В случае с изображениями некоторые из этих сигналов генерируются с помощью компьютерного зрения, но алгоритмы SafeSearch также учитывают более простые вещи, такие как то, где изображение использовалось ранее и в каком контексте оно применялось.
Тем не менее, одним из самых сильных сигналов являются страницы, помеченные как контент для взрослых. Мы рекомендуем веб-мастерам, публикующим контент для взрослых, размечать свои страницы с помощью одного из следующих мета тегов:
Многие пользователи предпочитают не включать контент для взрослых в результаты поиска (особенно если за тем же компьютером сидят дети). Когда веб-мастер предоставляет один из этих мета тегов, это помогает улучшить пользовательский опыт, так как пользователи не видят результаты, которые они не хотят или не ожидают увидеть.
Как и в случае со всеми алгоритмами, иногда SafeSearch может случайно отфильтровывать контент. Если вы считаете, что ваши изображения или страницы ошибочно фильтруются SafeSearch, пожалуйста, сообщите нам об этом на
Форуме справки для веб-мастеров.
Если вам нужна дополнительная информация о том, как мы индексируем изображения, ознакомьтесь с разделом нашего справочного центра, посвященным изображениям, прочитайте наше Руководство для начинающих по SEO
, которое содержит много полезной информации, и если у вас возникнут дополнительные вопросы, пожалуйста, задайте их на
Форуме справки для веб-мастеров.
Как мы это применяем
We archive Search Central announcements because client questions often trace back to a change that was announced years ago. Reading the original is faster than reconstructing it from second-hand summaries.
Связанные услуги