Mittwoch, 15. August 2007
Wir haben das robots.txt-Analysetool der Webmaster Central verbessert, sodass es Sitemap-Deklarationen und relative URLs erkennt. Frühere Versionen kannten Sitemaps überhaupt nicht und verstanden nur absolute URLs; alles andere wurde gemeldet als Syntax nicht verstanden. Die verbesserte Version teilt Ihnen nun mit, ob URL und Gültigkeitsbereich Ihrer Sitemap gültig sind. Sie können außerdem mit viel weniger Tipparbeit Tests gegen relative URLs durchführen.
Auch die Berichterstellung ist besser. Ihnen werden jetzt bei Bedarf mehrere Probleme pro Zeile gemeldet, im Gegensatz zu früheren Versionen, die nur das jeweils erste gefundene Problem meldeten. Zudem haben wir weitere allgemeine Verbesserungen an der Analyse und Validierung vorgenommen.
Stellen Sie sich vor, Sie sind verantwortlich für die Domain www.example.com und möchten, dass Suchmaschinen alles auf Ihrer Website indexieren, außer Ihrem /images Ordner. Sie möchten außerdem sicherstellen, dass Ihre Sitemap wahrgenommen wird, speichern Sie also Folgendes als Ihre robots.txt-Datei ab:
Sie besuchen die Webmaster Central, um Ihre Website mithilfe dieser beiden Test-URLs mit dem robots.txt-Analysetool zu testen:
Frühere Versionen des Tools hätten Folgendes gemeldet:
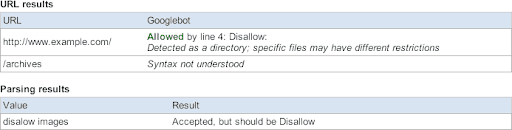
Die verbesserte Version verrät Ihnen mehr über diese robots.txt-Datei:
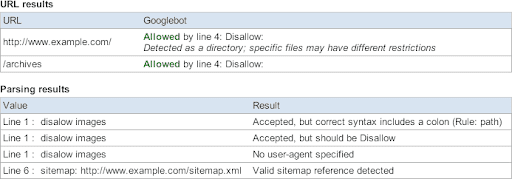
Überzeugen Sie sich selbst unter
https://www.google.com/webmasters/tools.
Wir möchten außerdem sicherstellen, dass Sie von dem neuen unavailable_after meta -Tag
gehört haben, das von Dan Crow vor einigen Wochen im
Offiziellen Google Blog angekündigt wurde. Dies ermöglicht eine dynamischere Beziehung zwischen Ihrer Website und dem Googlebot. Stellen Sie sich vor: Mitwww.example.com
können Sie jedes Mal, wenn Sie eine temporär verfügbare Nachricht, ein zeitlich begrenztes Sonderangebot oder eine Promotionsseite haben, genau Datum und Uhrzeit festlegen, zu denen bestimmte Seiten nicht mehr gecrawlt und indexiert werden sollen.
Nehmen wir an, Sie schalten eine Werbeaktion, die Ende 2007 ausläuft. In den Headern der Seitewww.example.com/2007promotion.html
würden Sie Folgendes verwenden: Die zweite spannende Neuigkeit: die neue X-Robots-Tag
-Regel, die
Robots Exclusion Protocol (REP) -meta -Tag-Unterstützung für Nicht-HTML-Seiten hinzufügt! Endlich haben Sie dieselbe Kontrolle über Ihre Videos, Tabellen und andere indexierte Dateitypen. Nehmen wir an, im obigen Beispiel befindet sich Ihre Promotionsseite im PDF-Format. Fürwww.example.com/2007promotion.pdf
würden Sie Folgendes verwenden: Denken Sie daran, dass REP -meta
-Tags nützlich sein können, um noarchive-, nosnippet- und jetzt unavailable_after
-Tags für Anweisungen auf Seitenebene zu implementieren, im Gegensatz zu robots.txt, das auf Domain-Root-Ebene gesteuert wird. Wir erhalten Anfragen von Bloggern und Webmastern für diese Features, also viel Spaß damit. Wenn Sie weitere Vorschläge haben, immer her damit. Noch Fragen? Bitte stellen Sie diese in der.
So setzen wir das um
We archive Search Central announcements because client questions often trace back to a change that was announced years ago. Reading the original is faster than reconstructing it from second-hand summaries.
Verwandte Leistungen