Среда, 15 августа 2007 г.
Мы усовершенствовали инструмент анализа robots.txt в Webmaster Central, чтобы он распознавал объявления Sitemap и относительные URL-адреса. Предыдущие версии вообще не распознавали файлы Sitemap и понимали только абсолютные URL-адреса; все остальное фиксировалось как Синтаксис не понят. Улучшенная версия теперь сообщает, являются ли URL-адрес и область действия вашего Sitemap действительными. Вы также можете тестировать относительные URL-адреса, затрачивая гораздо меньше усилий на ввод.
Отчетность также стала лучше. Теперь вам будет сообщаться о нескольких проблемах в одной строке, если они существуют (в отличие от предыдущих версий, которые сообщали только о первой обнаруженной проблеме). Кроме того, мы внесли и другие общие улучшения в анализ и валидацию.
Представьте, что вы отвечаете за домен www.example.com и хотите, чтобы поисковые системы индексировали все на вашем сайте, за исключением папки /images . Вы также хотите убедиться, что ваш Sitemap замечен, поэтому сохраните следующий текст в качестве файла robots.txt:
Вы заходите в Webmaster Central, чтобы протестировать свой сайт с помощью инструмента анализа robots.txt, используя эти два тестовых URL-адреса:
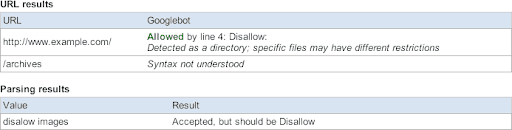
Предыдущие версии инструмента сообщили бы об этом следующее:
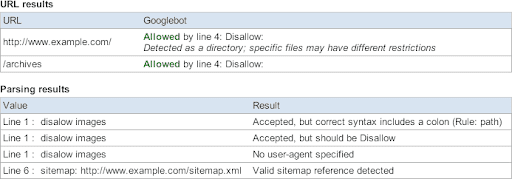
Улучшенная версия сообщает больше подробностей об этом файле robots.txt:
Убедитесь сами на
https://www.google.com/webmasters/tools.
Мы также хотим убедиться, что вы слышали о новом unavailable_after мета теге
, анонсированном Дэном Кроу в
Официальном блоге Google несколько недель назад. Это обеспечивает более динамичные отношения между вашим сайтом и Googlebot. Только подумайте: с помощьюwww.example.com
, всякий раз, когда у вас появляется временно доступная новостная статья, страница ограниченного по времени предложения или распродажи либо промостраница, вы можете указать точные дату и время, когда определенные страницы должны перестать сканироваться и индексироваться.
Предположим, вы проводите акцию, которая заканчивается в конце 2007 года. В заголовках страницыwww.example.com/2007promotion.html
, вы бы использовали следующее: Вторая захватывающая новость: новое правило X-Robots-Tag
, которое добавляет поддержку метатеги
Robots Exclusion Protocol (REP) meta для страниц, не содержащих HTML! Наконец-то вы можете получить такой же контроль над вашими видео, электронными таблицами и другими индексируемыми типами файлов. Используя пример выше, предположим, что ваша промостраница находится в формате PDF. Дляwww.example.com/2007promotion.pdf
, вы бы использовали следующее: Помните, что метатеги REP
мета теги могут быть полезны для реализации тегов noarchive, nosnippet и теперь
unavailable_after.
Как мы это применяем
We archive Search Central announcements because client questions often trace back to a change that was announced years ago. Reading the original is faster than reconstructing it from second-hand summaries.
Связанные услуги