Miércoles, 15 de agosto de 2007
Hemos mejorado la herramienta de análisis de robots.txt de Webmaster Central para reconocer declaraciones de Sitemap y URLs relativas. Las versiones anteriores no reconocían los Sitemaps en absoluto y solo entendían URLs absolutas; cualquier otra cosa se informaba como Sintaxis no entendida. La versión mejorada ahora le indica si la URL y el ámbito de su Sitemap son válidos. También puede realizar pruebas con URLs relativas escribiendo mucho menos.
Los informes también son mejores. Ahora se le informará de múltiples problemas por línea si existen, a diferencia de las versiones anteriores que solo informaban del primer problema encontrado. Y hemos realizado otras mejoras generales en el análisis y la validación.
Imagine que es responsable del dominio www.example.com y desea que los motores de búsqueda indexen todo en su sitio, excepto su carpeta /images . También desea asegurarse de que su Sitemap sea detectado, por lo que guarda lo siguiente como su archivo robots.txt:
Visita Webmaster Central para probar su sitio con la herramienta de análisis de robots.txt utilizando estas dos URLs de prueba:
Las versiones anteriores de la herramienta habrían informado de esto:
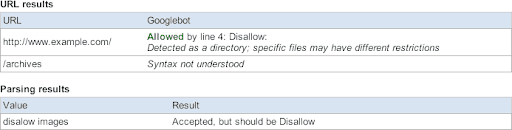
La versión mejorada le cuenta más sobre ese archivo robots.txt:
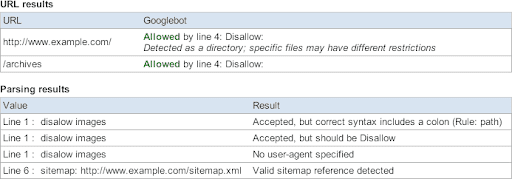
Compruébelo usted mismo en
https://www.google.com/webmasters/tools.
También queremos asegurarnos de que se ha enterado de la nueva etiqueta unavailable_after meta anunciada por Dan Crow en el
Blog oficial de Google
hace unas semanas. Esto permite una relación más dinámica entre su sitio y Googlebot. Piénselo, con www.example.com, cada vez que tenga una noticia disponible temporalmente o una página de venta u oferta promocional limitada, puede especificar la fecha y hora exactas en que desea que páginas específicas dejen de ser rastreadas e indexadas.
Supongamos que está ejecutando una promoción que expira a finales de 2007. En los encabezados de la página
www.example.com/2007promotion.html, utilizaría lo siguiente:
La segunda noticia emocionante: la nueva regla X-Robots-Tag , que añade soporte de etiquetas
Robots Exclusion Protocol
(REP) meta para páginas que no son HTML. ¡Por fin puede tener el mismo control sobre sus vídeos, hojas de cálculo y otros tipos de archivos indexados. Usando el ejemplo anterior, digamos que su página de promoción está en formato PDF. Para www.example.com/2007promotion.pdf, utilizaría lo siguiente:
Recuerde que las etiquetas REP meta pueden ser útiles para implementar etiquetas noarchive, nosnippet y ahora
unavailable_after para instrucciones a nivel de página, en lugar de robots.txt, que se controla en la raíz del dominio. Recibimos peticiones de blogueros y webmasters para estas funciones, así que disfrútelas. Si tiene otras sugerencias, siga enviándolas. ¿Alguna pregunta? Por favor, hágalas en el
Grupo de ayuda para webmasters.
Cómo lo aplicamos
We archive Search Central announcements because client questions often trace back to a change that was announced years ago. Reading the original is faster than reconstructing it from second-hand summaries.
Servicios relacionados