Mercredi 15 août 2007
Nous avons amélioré l’outil d’analyse robots.txt de Webmaster Central afin qu’il reconnaisse les déclarations Sitemap et les URL relatives. Les versions précédentes ne prenaient pas du tout en compte les Sitemaps et ne comprenaient que les URL absolues ; tout le reste était signalé comme Syntaxe non comprise. La version améliorée vous indique désormais si l’URL et la portée de votre Sitemap sont valides. Vous pouvez également effectuer des tests par rapport à des URL relatives en tapant beaucoup moins.
Les rapports sont également meilleurs. Vous êtes désormais informé de plusieurs problèmes par ligne le cas échéant, contrairement aux versions précédentes qui ne signalaient que le premier problème rencontré. Nous avons également apporté d’autres améliorations générales à l’analyse et à la validation.
Imaginez que vous êtes responsable du domaine www.example.com et que vous souhaitez que les moteurs de indexent tout sur votre site, à l’exception de votre dossier /images . Vous souhaitez également vous assurer que votre Sitemap est pris en compte, vous enregistrez donc le code suivant comme fichier robots.txt :
Vous visitez Webmaster Central pour tester votre site avec l’outil d’analyse robots.txt en utilisant ces deux URL de test :
Les versions précédentes de l’outil auraient signalé ceci :
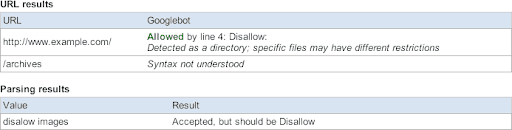
La version améliorée vous en dit plus sur ce fichier robots.txt :
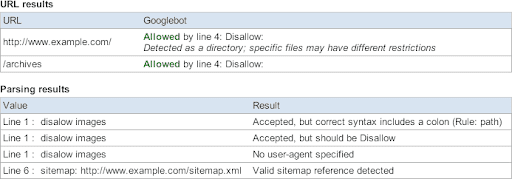
Découvrez-le par vous-même sur
https://www.google.com/webmasters/tools.
Nous souhaitons également nous assurer que vous avez entendu parler de la nouvelle balise unavailable_after méta annoncée par Dan Crow sur le
Blog officiel de Google
il y a quelques semaines. Cela permet une relation plus dynamique entre votre site et Googlebot. Pensez-y, avec www.example.com, chaque fois que vous disposez d’une actualité temporaire, d’une offre à durée limitée ou d’une page promotionnelle, vous pouvez spécifier la date et l’heure exactes où vous souhaitez que des pages spécifiques cessent d’être explorées et indexées.
Supposons que vous lanciez une promotion qui expire fin 2007. Dans les en-têtes de la page
www.example.com/2007promotion.html, vous utiliseriez ce qui suit :
La deuxième grande nouvelle : la nouvelle règle X-Robots-Tag , qui ajoute la prise en charge des balises
Robots Exclusion Protocol
(REP) méta pour les pages non HTML ! Enfin, vous bénéficiez du même contrôle sur vos vidéos, feuilles de calcul et autres types de fichiers indexés. En reprenant l’exemple ci-dessus, imaginons que votre page promotionnelle soit au format PDF. Pour www.example.com/2007promotion.pdf, vous utiliseriez ce qui suit :
N’oubliez pas que les balises méta REP peuvent être utiles pour implémenter les balises noarchive, nosnippet et désormais
unavailable_after pour des instructions au niveau de la page, par opposition au fichier robots.txt, qui est contrôlé à la racine du domaine. Nous recevons des demandes de blogueurs et de webmasters pour ces fonctionnalités, alors profitez-en. Si vous avez d’autres suggestions, continuez à nous les envoyer. Des questions ? Veuillez les poser dans le
Groupe d’aide aux webmasters.
Comment nous l'appliquons
We archive Search Central announcements because client questions often trace back to a change that was announced years ago. Reading the original is faster than reconstructing it from second-hand summaries.
Services associés