Dienstag, 3. Dezember 2024
Sie haben vielleicht gehört, dass die Google Suche ein wenig Arbeit leisten muss, bevor eine Webseite in den Google Suche-Ergebnissen erscheinen kann. Einer dieser Schritte nennt sich Crawling. Das Crawling für die Google Suche wird vom Googlebot durchgeführt, einem Programm auf Google-Servern, das eine URL abruft und Netzwerkfehler, Weiterleitungen und andere kleine Komplikationen verarbeitet, denen es bei seiner Arbeit im Web begegnen kann. Aber es gibt ein paar Details, über die selten gesprochen werden. Jede Woche in diesem Monat werden wir einige dieser Details untersuchen, da sie einen erheblichen Einfluss darauf haben können, wie Ihre Websites gecrawlt werden.
Etwas weiter ausgeholt: Was ist Crawling?
Crawling ist der Prozess des Entdeckens neuer und des erneuten Besuchens aktualisierter Webseiten sowie deren Herunterladen. Kurz gesagt, der Googlebot erhält eine URL, stellt eine HTTP-Anfrage an den Server, der sie gehostet, und verarbeitet dann die Antwort dieses Servers, wobei er möglicherweise Weiterleitungen folgt, Fehler behandelt und den Seiteninhalt an das Indexierungssystem von Google weiterleitet.
Aber moderne Webseiten bestehen nicht nur aus reinem HTML, wie sieht es also mit den anderen Ressourcen aus, die eine Seite ausmachen? Wie wirkt sich das Crawling dieser Ressourcen auf das „Crawl-Budget“ aus? Sind diese Ressourcen auf Seiten von Google cachefähig? Und gibt es einen Unterschied zwischen URLs, die noch nie gecrawlt wurden, und solchen, die bereits indexiert sind? In diesem Beitrag werden wir diese Fragen und noch mehr beantworten!
Googlebot und das Crawling von Seitenressourcen
Über HTML hinaus nutzen moderne Websites eine Kombination verschiedener Technologien wie JavaScript und CSS, um Nutzern lebendige Erlebnisse und nützliche Funktionen zu bieten. Beim Zugriff auf solche Seiten mit einem Browser lädt dieser zuerst die übergeordnete URL herunter, die die Daten hostet, die zum Starten des Aufbaus der Seite für den Nutzer benötigt werden — das HTML der Seite. Diese anfänglichen Daten können Verweise auf Ressourcen wie JavaScript und CSS enthalten, aber auch Bilder und Videos, die der Browser erneut herunterlädt, um schließlich die endgültige Seite zu konstruieren, die dann dem Nutzer präsentiert wird.
Google tut genau dasselbe, wenngleich etwas anders:
- Der Googlebot lädt die anfänglichen Daten von der übergeordneten URL herunter — dem HTML der Seite.
- Der Googlebot leitet die abgerufenen Daten an den Web Rendering Service (WRS) weiter.
- Mithilfe des Googlebot lädt der WRS die in den Originaldaten referenzierten Ressourcen herunter.
- Der WRS konstruiert die Seite unter Verwendung aller heruntergeladenen Ressourcen wie der Browser eines Nutzers.
Im Vergleich zu einem Browser kann die Zeit zwischen den einzelnen Schritten aufgrund von Planungsbeschränkungen, wie der wahrgenommenen Last des Servers, der die für das Rendering benötigten Ressourcen hostet, erheblich länger sein. Und hier schleicht sich
das Crawling-Budget
ins Gespräch ein.
Das Crawling der für das Rendern einer Seite benötigten Ressourcen verbraucht einen Teil des Crawl-Budgets des Hostnamens, der die Ressource hostet. Um dem entgegenzuwirken, versucht der WRS, jede Ressource (JavaScript und CSS), auf die in den von ihm gerenderten Seiten verwiesen wird, zu cachen. Die Gültigkeitsdauer (TTL) des WRS-Caches wird von HTTP-Caching-Direktiven nicht beeinflusst; stattdessen cachet der WRS alles für bis zu 30 Tage, was dazu beiträgt, das Crawl-Budget der Website für andere Crawling-Aufgaben zu schonen.
Aus Sicht der Website-Betreiber kann die Verwaltung, wie und welche Ressourcen gecrawlt werden, das Crawl-Budget der Website beeinflussen; wir empfehlen:
- Verwenden Sie so wenige Ressourcen wie machbar um Nutzern ein großartiges Erlebnis zu bieten; je weniger Ressourcen für das Rendering einer Seite benötigt werden, desto weniger Crawl-Budget wird beim Rendering verbraucht.
- Verwenden Sie Cache-Busting-Parameter mit Vorsicht: Wenn sich die URLs von Ressourcen ändern, muss Google die Ressourcen möglicherweise erneut crawlen, selbst wenn sich ihr Inhalt nicht geändert hat. Dies verbraucht natürlich Crawl-Budget.
- Hosten Sie Ressourcen auf einem anderen Hostnamen als der Haupt-Website, zum Beispiel durch den Einsatz eines CDN oder einfach durch das Hosten der Ressourcen auf einer anderen Subdomain. Dies verlagert Bedenken hinsichtlich des Crawl-Budgets auf den Host, der die Ressourcen bereitstellt.
All diese Punkte gelten auch für Medienressourcen. Wenn der Googlebot (oder genauer gesagt,
Googlebot-Image und Googlebot-Video jeweils) diese abruft, verbraucht dies das Crawl-Budget der Website.
Es ist verlockend, auch robots.txt zur Liste hinzuzufügen, jedoch führt das Verhindern des Crawlings von Ressourcen aus Rendering-Sicht normalerweise zu Problemen. Wenn der WRS eine für das Rendering kritische Ressource nicht abrufen kann, hat die Google Suche möglicherweise Schwierigkeiten, den Inhalt der Seite zu extrahieren und der Seite zu ermöglichen, in der Suche zu ranken.
Was ist Googlebot-Crawling?
Die beste Quelle, um zu analysieren, welche Ressourcen Google crawlt, sind die rohen Zugriffs-Logs der Website, die für jede URL, die sowohl von Browsern als auch von Crawlern angefordert wurde, einen Eintrag enthalten. Um die Crawler von Google im Zugriffs-Log zu identifizieren, veröffentlichen wir unsere
IP-Bereiche in unserer Entwicklerdokumentation.
Die zweitbeste Ressource ist natürlich der
Search Console Crawl-Statistik-Bericht, der jede Art von Ressource nach Crawler aufschlüsselt:
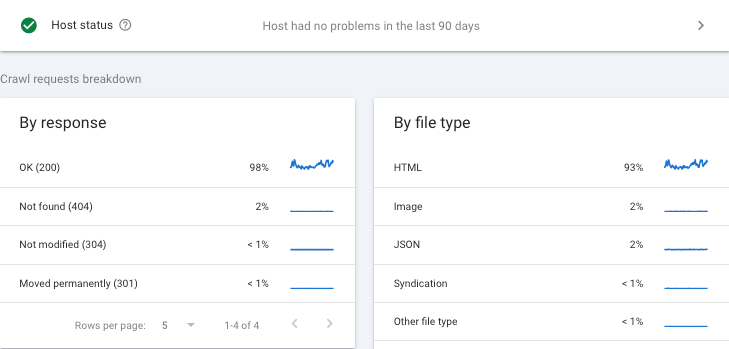
Schließlich, wenn Sie sich wirklich für Crawling und Rendering interessieren und sich mit anderen darüber austauschen möchten, ist die
Search Central Community die richtige Anlaufstelle, aber Sie finden uns auch auf
LinkedIn.
Aktualisierungen
- Aktualisierung vom 6. Dezember 2024: Leistungsauswirkungen beim Bereitstellen von Ressourcen von einem anderen Ursprung festgestellt.
Möchten Sie mehr über das Crawling erfahren? Schauen Sie sich die gesamte Crawling December-Reihe an:
So setzen wir das um
Google announcements age. We keep this post here for the record, and we note for clients whether the behaviour it describes still applies today or has since been superseded.
Verwandte Leistungen