3 dekabr 2024-cü il, çərşənbə axşamı
Eşitmiş ola bilərsiniz ki, Google Axtarış nəticələrində veb-səhifənin görünməsi üçün əvvəlcə bir qədər iş görməlidir. Bu addımlardan biri tarama (crawling) adlanır. Google Axtarış üçün tarama Google serverlərində işləyən və URL-i əldə edərək şəbəkə xətaları, yönləndirmələr və internetdə işləyərkən qarşılaşa biləcəyidigər kiçik çətinlikləri idarə edən proqram — Googlebot tərəfindən həyata keçirilir. Lakin haqqında çox danışılmayan bəzi detallar var. Bu ay hər həftə saytlarınızın taranmasına əhəmiyyətli dərəcədə təsir edə biləcək bu detallardan bəzilərini araşdıracağıq.
Bir az geriyə qayıdaq: Tarama nədir?
Tarama yeni və yenilənmiş veb-səhifələrin aşkar edilməsi, yenidən ziyarət edilməsi və endirilməsi prosesidir. Qısası, Googlebot URL əldə edir, onu qəbul edən serverə HTTP sorğusu göndərir və sonra həmin serverdən gələn cavabla işləyir, ehtimal ki, yönləndirmələri izləyir, səhvləri idarə edir və səhifə məzmununu Google-un indeksləşdirmə sisteminə ötürür.
Lakin müasir veb-səhifələr sadəcə xam HTML deyil, bəs səhifəni təşkil edən digər resurslar necə? Bu resursların taranması “tarama büdcəsinə” necə təsir edir? Bu resurslar Google tərəfindən keşlənə bilirmi? Və əvvəllər tarandığı olmayan URL-lərlə artıq indekslənmiş URL-lər arasında fərq varmı? Bu yazıda biz bu sualları və daha çoxunu cavablandıracağıq!
Googlebot və səhifə resurslarının taranması
HTML-dən əlavə, müasir veb-saytlar istifadəçilərə canlı təcrübələr və faydalı funksionallıqlar təqdim etmək üçün JavaScript və CSS kimi müxtəlif texnologiyaların kombinasiyasından istifadə edir. Brauzer ilə belə səhifələrə daxil olarkən, brauzer əvvəlcə istifadəçi üçün səhifənin qurulmasına başlamaq üçün lazım olan məlumatları ehtiyac duyulan əsas URL-i — səhifənin HTML-ini endirir. Bu ilkin məlumatda JavaScript və CSS kimi resurslara istinadlar, eləcə də brauzerin nəticə etibarilə istifadəçiyə təqdim ediləcək son səhifəni qurmaq üçün yenidən endirəcəyi şəkillər və videolar ola bilər.
Google da eyni şeyi edir, baxmayaraq ki, bir qədər fərqli şəkildə:
- Googlebot ilkin məlumatları ana URL-dən — səhifənin HTML-indən endirir.
- Googlebot əldə edilmiş məlumatları Veb Rendersinq Xidmətinə (WRS) ötürür.
- Googlebot-dan istifadə edərək, WRS orijinal məlumatda istinad edilən resursları endirir.
- WRS istifadəçinin brauzeri kimi endirilmiş bütün resurslardan istifadə edərək səhifəni qurur.
Brauzerlə müqayisədə, hər bir addım arasındakı vaxt səhifənin render edilməsi üçün tələb olunan resursların yerləşdiyi serverin qəbul edilən yükü kimi planlaşdırma məhdudiyyətlərinə görə əhəmiyyətli dərəcədə uzun ola bilər. Və məhz buradan
tarama büdcəsi
mövzuya daxil olur.
Səhifəni render etmək üçün tələb olunan resursların taranması resursu yerləşdirən hostinq adının tarama büdcəsini azaldacaq. Bunu yaxşılaşdırmaq üçün WRS render etdiyi səhifələrdə istinad edilən hər bir resursu (JavaScript və CSS) keşləməyə çalışır. WRS keşinin yaşama müddəti HTTP keşləmə direktivlərindən təsirlənmir; bunun əvəzinə WRS digər tarama tapşırıqları üçün saytın tarama büdcəsini qorumağa kömək edən hər şeyi 30 günə qədər keşləyir.
Sayt sahiblərinin nöqteyi-nəzərindən, resursların necə və nəyə uyğun tarandığını idarə etmək saytın tarama büdcəsinə təsir edə bilər; biz tövsiyə edirik:
- Mümkün qədər az resursdan istifadə edin İstifadəçilərə əla təcrübə təqdim etmək üçün; səhifəni render etmək üçün nə qədər az resurs tələb olunursa, render zamanı bir o qədər az tarama büdcəsi xərclənir.
- Keşləməni pozan parametrlərdən ehtiyatla istifadə edin: əgər resursların URL-ləri dəyişərsə, məzmunu dəyişməsə belə, Google resursları yenidən taraya bilər. Bu, təbii ki, tarama büdcəsini sərf edəcək.
- Resursları fərqli hostinq adında yerləşdirin məsələn, CDN tətbiq etməklə və ya sadəcə resursları fərqli alt domendə yerləşdirməklə əsas saytdan kənarda. Bu, tarama büdcəsi ilə bağlı narahatlıqları resurslara xidmət edən hosta yönəldəcək.
Bütün bu məqamlar media resurslarına da aiddir. Əgər Googlebot (və ya daha dəqiq desək,
Googlebot-Image və Googlebot-Video müvafiq olaraq) onları əldə edərsə, o, saytın tarama büdcəsini sərf edəcək.
Siyahıya robots.txt faylını da əlavə etmək cazibədar ola bilər, lakin render baxımından resursların taranmasına icazə verilməməsi adətən problemlər yaradır. WRS render üçün kritik olan resursu əldə edə bilmirsə, Google Axtarış səhifənin məzmununu çıxarmaqda çətinlik çəkə bilər və səhifənin Axtarışda reytinq qazanmasına mane ola bilər.
Googlebot taraması nədir?
Google-un hansı resursları taradığını təhlil etmək üçün ən yaxşı mənbə həm brauzerlər, həm də skanerlər tərəfindən tələb olunan hər bir URL üçün qeydi olan saytın xam giriş loqlarıdır. Giriş loqunda Google-un skanerlərini müəyyən etmək üçün biz
İP diapazonlarımızı tərtibatçı sənədlərimizdə dərc edirik.
İkinci ən yaxşı mənbə, əlbəttə ki,
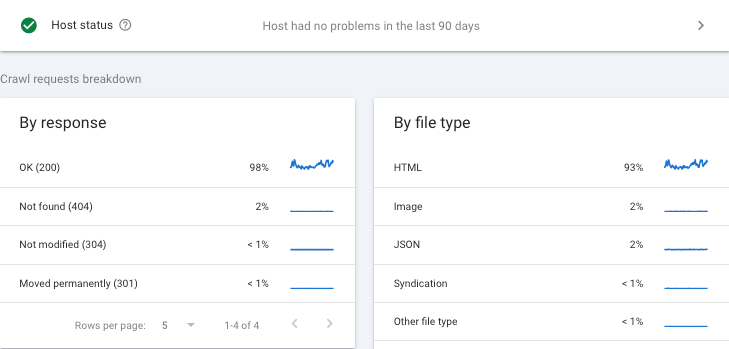
Search Console Crawl Stats hesabatıdır, hansı ki, hər bir resurs növünü hər bir skanerə görə ayırır:
Nəhayət, əgər həqiqətən tarama və render ilə maraqlanırsınızsa və başqaları ilə bu barədə söhbət etmək istəyirsinizsə,
Search Central icması getmək üçün ən yaxşı yerdir, lakin bizi həm də bəzi yerlərdə tapa bilərsiniz
LinkedIn.
Yeniləmələr
- 6 dekabr 2024-cü il tarixli yeniləmə: Fərqli mənşədən resursların təqdim edilməsinin performans təsiri qeyd edildi.
Tarama haqqında daha çox öyrənmək istəyirsiniz? Bütün Tarama Dekabrı seriyasına baxın:
Bunu necə tətbiq edirik
Google announcements age. We keep this post here for the record, and we note for clients whether the behaviour it describes still applies today or has since been superseded.
Əlaqəli xidmətlər