3 Aralık 2024, Salı
Google Arama’nın, bir web sayfasının Google Arama sonuçlarında görünebilmesi için biraz çalışma yapması gerektiğini duymuş olabilirsiniz. Bu adımlardan biri tarama olarak adlandırılır. Google Arama için tarama, Google sunucularında çalışan ve bir URL’yi alıp ağ hataları, yönlendirmeler ve web üzerinde çalışırken karşılaşabileceği diğer küçük komplikasyonlar gibi durumları yöneten bir program olan Googlebot tarafından gerçekleştirilir. Ancak, genellikle konuşulmayan birkaç detay var. Bu ay her hafta, sitelerinizin nasıl tarandığı üzerinde önemli bir etkisi olabileceğinden bu detaylardan bazılarını inceleyeceğiz.
Biraz geriye gidelim: Tarama nedir?
Tarama , yeni web sayfalarını keşfetme ve güncellenmiş sayfaları tekrar ziyaret edip indirme sürecidir. Kısacası Googlebot bir URL alır, onu barındıran sunucuya bir HTTP isteği gönderir ve ardından o sunucudan gelen yanıtla ilgilenir; gerekirse yönlendirmeleri takip eder, hataları yönetir ve sayfa içeriğini Google’ın dizine ekleme sistemine aktarır.
Ancak modern web sayfaları sadece saf HTML’den oluşmaz, peki ya bir sayfayı oluşturan diğer kaynaklar ne olacak? Bu kaynakları taramak “tarama bütçesini” nasıl etkiler? Bu kaynaklar Google tarafında önbelleğe alınabilir mi? Ayrıca daha önce taranmamış URL’ler ile halihazırda dizine eklenmiş olanlar arasında bir fark var mı? Bu yazımızda bu soruları ve daha fazlasını yanıtlayacağız!
Googlebot ve sayfa kaynaklarını tarama
HTML’nin ötesinde, modern web siteleri kullanıcılara canlı deneyimler ve yararlı işlevler sunmak için JavaScript ve CSS gibi farklı teknolojilerin bir kombinasyonunu kullanır. Bir tarayıcı ile bu tür sayfalara erişildiğinde, tarayıcı önce sayfanın kullanıcı için oluşturulmaya başlanması için gereken verileri barındıran ana URL’yi, yani sayfanın HTML’sini indirir. Bu ilk veriler, JavaScript ve CSS gibi kaynaklara referanslar içerebilir, ancak tarayıcının nihai sayfayı oluşturmak için tekrar indireceği resimler ve videolar da bulunabilir; bu sayfa daha sonra kullanıcıya sunulur.
Google da tam olarak aynı şeyi yapar, ancak biraz farklı bir şekilde:
- Googlebot, ana URL’den ilk verileri, yani sayfanın HTML’sini indirir.
- Googlebot, getirilen verileri Web İşleme Hizmetine (WRS) aktarır.
- WRS, Googlebot kullanarak orijinal verilerde referans verilen kaynakları indirir.
- WRS, bir kullanıcının tarayıcısının yapacağı gibi indirilen tüm kaynakları kullanarak sayfayı oluşturur.
Bir tarayıcıya kıyasla, her adım arasındaki süre, bir sayfanın oluşturulması için gereken kaynakları barındıran sunucunun algılanan yükü gibi zamanlama kısıtlamaları nedeniyle önemli ölçüde daha uzun olabilir. İşte tam bu noktada
tarama bütçesi
konuşmaya dahil olur.
Bir sayfayı oluşturmak için gereken kaynakları taramak, kaynağı barındıran ana bilgisayar adının tarama bütçesinden eksiltir. Bunu iyileştirmek için WRS, oluşturduğu sayfalarda referans verilen her kaynağı (JavaScript ve CSS) önbelleğe almaya çalışır. WRS önbelleğinin yaşam süresi (TTL), HTTP önbelleğe alma yönergelerinden etkilenmez; bunun yerine WRS, sitenin tarama bütçesini diğer tarama görevleri için korumaya yardımcı olmak amacıyla her şeyi 30 güne kadar önbelleğe alır.
Site sahipleri açısından, kaynakların nasıl ve nelerin tarandığını yönetmek sitenin tarama bütçesini etkileyebilir; şunları öneriyoruz:
- Mümkün olduğunca az kaynak kullanın , kullanıcılara harika bir deneyim sunmak için; bir sayfanın oluşturulması için ne kadar az kaynak gerekirse, oluşturma sırasında o kadar az tarama bütçesi harcanır.
- Önbellek temizleme (cache-busting) parametrelerini dikkatli kullanın: kaynakların URL’leri değişirse, içerikleri değişmemiş olsa bile Google’ın kaynakları tekrar taraması gerekebilir. Bu elbette tarama bütçesini tüketecektir.
- Kaynakları farklı bir ana bilgisayar adında barındırın , örneğin bir CDN kullanarak veya kaynakları farklı bir alt alan adında barındırarak. Bu, tarama bütçesi endişelerini kaynakları sunan ana bilgisayara kaydıracaktır.
Tüm bu noktalar medya kaynakları için de geçerlidir. Eğer Googlebot (veya daha spesifik olarak,
Googlebot-Image ve Googlebot-Video ) bunları getirirse, sitenin tarama bütçesini tüketecektir.
Listeye robots.txt dosyasını da eklemek cazip gelebilir, ancak oluşturma perspektifinden bakıldığında kaynakların taranmasına izin vermemek genellikle sorunlara yol açar. WRS, oluşturma için kritik bir kaynağı getiremezse, Google Arama sayfanın içeriğini çıkarmakta ve sayfanın Arama’da sıralanmasını sağlamakta zorluk yaşayabilir.
Googlebot neyi tarıyor?
Google’ın hangi kaynakları taradığını analiz etmek için en iyi kaynak, hem tarayıcılar hem de botlar tarafından istenen her URL için bir girişi olan sitenin ham erişim günlükleridir. Erişim günlüğünde Google’ın tarayıcılarını tanımlamak için
geliştirici belgelerimizde IP aralıklarımızı.
yayınlıyoruz. İkinci en iyi kaynak elbette
Search Console Tarama İstatistikleri raporudur, bu rapor her kaynak türünü tarayıcıya göre ayırır:
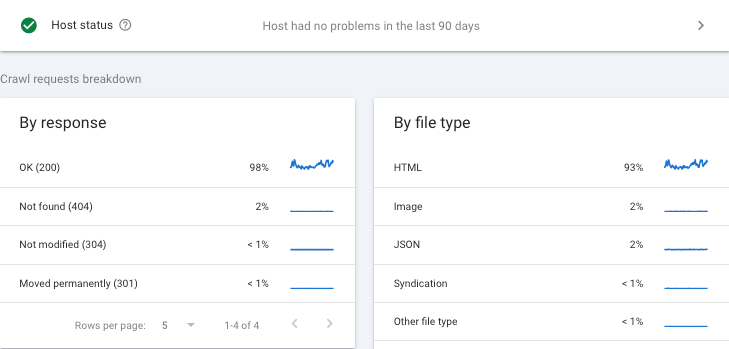
Son olarak, tarama ve oluşturma ile gerçekten ilgileniyorsanız ve başkalarıyla bu konuda sohbet etmek istiyorsanız,
Search Central topluluğu gidebileceğiniz yerdir, ancak bizi ayrıca
LinkedIn.
Güncellemeler
- 6 Aralık 2024 güncellemesi: Kaynakların farklı bir kaynaktan sunulmasının performans üzerindeki etkisi belirtildi.
Tarama hakkında daha fazla bilgi mi istiyorsunuz? Tüm Aralık Ayında Tarama serisine göz atın:
Biz bunu nasıl uyguluyoruz
Google announcements age. We keep this post here for the record, and we note for clients whether the behaviour it describes still applies today or has since been superseded.
İlgili hizmetler