Martes, 3 de diciembre de 2024
Es posible que hayas oído que la Búsqueda de Google necesita hacer un poco de trabajo antes de que una página web pueda aparecer en los resultados de la Búsqueda de Google. Uno de estos pasos se llama rastreo. El rastreo para la Búsqueda de Google lo realiza Googlebot, un programa que se ejecuta en los servidores de Google que recupera una URL y gestiona cosas como errores de red, redirecciones y otras pequeñas complicaciones que pueda encontrar a medida que avanza por la web. Pero hay algunos detalles de los que no se suele hablar. Cada semana de este mes vamos a explorar algunos de esos detalles, ya que pueden tener un efecto significativo en cómo se rastrean tus sitios.
Retrocediendo un poco: ¿Qué es el rastreo?
El rastreo es el proceso de descubrir páginas web nuevas y volver a visitar las actualizadas, y descargarlas. En resumen, Googlebot obtiene una URL, realiza una solicitud HTTP al servidor que la aloja y luego gestiona la respuesta de ese servidor, posiblemente siguiendo redirecciones, manejando errores y pasando el contenido de la página al sistema de indexación de Google.
Pero las páginas web modernas no son solo HTML puro, entonces, ¿qué pasa con los otros recursos que componen una página? ¿Cómo afecta el rastreo de estos recursos al “presupuesto de rastreo”? ¿Se pueden almacenar estos recursos en caché del lado de Google? ¿Y hay alguna diferencia entre las URL que no se han rastreado antes y las que ya están indexadas? ¡En esta publicación vamos a responder a estas preguntas y más!
Googlebot y el rastreo de recursos de páginas
Más allá de HTML, los sitios web modernos utilizan una combinación de diferentes tecnologías como JavaScript y CSS para ofrecer a los usuarios experiencias dinámicas y funcionalidades útiles. Al acceder a dichas páginas con un navegador, este descarga primero la URL principal que aloja los datos necesarios para empezar a construir la página para el usuario: el HTML de la página. Estos datos iniciales pueden contener referencias a recursos como JavaScript y CSS, pero también a imágenes y vídeos que el navegador volverá a descargar para construir finalmente la página final que luego se presenta al usuario.
Google hace exactamente lo mismo, aunque de forma ligeramente diferente:
- Googlebot descarga los datos iniciales de la URL principal: el HTML de la página.
- Googlebot transmite los datos recuperados al Servicio de Renderizado Web (WRS).
- Utilizando Googlebot, el WRS descarga los recursos referenciados en los datos originales.
- El WRS construye la página utilizando todos los recursos descargados como lo haría el navegador de un usuario.
En comparación con un navegador, el tiempo entre cada paso puede ser significativamente mayor debido a restricciones de programación, como la carga percibida del servidor que aloja los recursos necesarios para renderizar una página. Y aquí es donde
el presupuesto de rastreo
entra en juego en la conversación.
Rastrear los recursos necesarios para renderizar una página restará presupuesto de rastreo del nombre de host que aloja el recurso. Para solucionar esto, el WRS intenta almacenar en caché cada recurso (JavaScript y CSS) referenciado en las páginas que renderiza. El tiempo de vida de la caché de WRS no se ve afectado por las directivas de almacenamiento en caché HTTP; en su lugar, el WRS almacena todo en caché hasta por 30 días, lo que ayuda a preservar el presupuesto de rastreo del sitio para otras tareas de rastreo.
Desde la perspectiva de los propietarios de sitios, gestionar cómo y qué recursos se rastrean puede influir en el presupuesto de rastreo del sitio; recomendamos:
- Utiliza los mínimos recursos posibles para ofrecer a los usuarios una gran experiencia; cuantos menos recursos se necesiten para renderizar una página, menos presupuesto de rastreo se gastará durante el renderizado.
- Usa los parámetros de evasión de caché con precaución: si las URL de los recursos cambian, es posible que Google tenga que volver a rastrear los recursos, incluso si sus contenidos no han cambiado. Esto, por supuesto, consumirá presupuesto de rastreo.
- Aloja los recursos en un nombre de host diferente al del sitio principal, por ejemplo, empleando una CDN o simplemente alojando los recursos en un subdominio diferente. Esto trasladará las preocupaciones sobre el presupuesto de rastreo al host que sirve los recursos.
Todos estos puntos se aplican también a los recursos multimedia. Si Googlebot (o más específicamente,
Googlebot-Image y Googlebot-Video respectivamente) los recupera, consumirá el presupuesto de rastreo del sitio.
Es tentador añadir robots.txt a la lista también; sin embargo, desde una perspectiva de renderizado, denegar el rastreo de recursos suele causar problemas. Si el WRS no puede recuperar un recurso crítico para el renderizado, es posible que la Búsqueda de Google tenga problemas para extraer el contenido de la página y permitir que la página se posicione en la Búsqueda.
¿Qué es el rastreo de Googlebot?
La mejor fuente para analizar qué recursos está rastreando Google son los registros de acceso brutos del sitio, que tienen una entrada para cada URL solicitada tanto por navegadores como por rastreadores. Para identificar a los rastreadores de Google en el registro de acceso, publicamos nuestros
rangos de IP en nuestra documentación para desarrolladores.
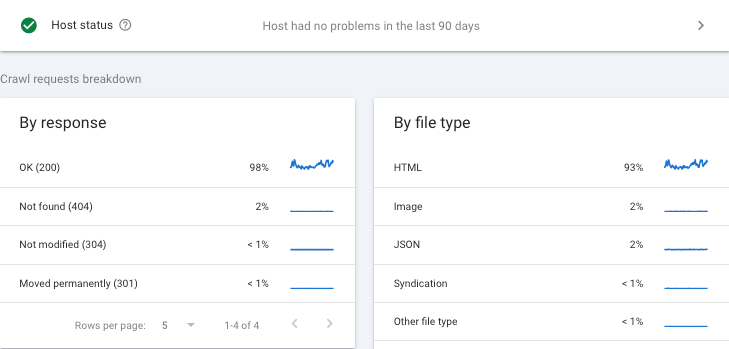
La segunda mejor fuente es, por supuesto,
el informe de estadísticas de rastreo de Search Console, que desglosa cada tipo de recurso por rastreador:
Por último, si te apasiona de verdad el rastreo y el renderizado y quieres charlar sobre ello con otros,
la comunidad de Search Central es el lugar al que acudir, pero también puedes encontrarnos en
LinkedIn.
Actualizaciones
- Actualización del 6 de diciembre de 2024: Se observó el impacto en el rendimiento al servir recursos desde un origen diferente.
¿Quieres saber más sobre el rastreo? Consulta toda la serie Crawling December:
Cómo lo aplicamos
Google announcements age. We keep this post here for the record, and we note for clients whether the behaviour it describes still applies today or has since been superseded.
Servicios relacionados