Mardi 3 décembre 2024
Vous avez peut-être entendu dire que la Recherche Google doit effectuer un certain travail avant qu’une page Web puisse apparaître dans les résultats de la Recherche Google. L’une de ces étapes s’appelle l’exploration (crawling). L’exploration pour la Recherche Google est effectuée par Googlebot, un programme s’exécutant sur les serveurs de Google qui récupère une URL et gère les erreurs réseau, les redirections et autres petites complications qu’il peut rencontrer lors de sa navigation sur le Web. Mais il y a quelques détails dont on parle peu. Chaque semaine ce mois-ci, nous allons explorer certains de ces détails, car ils peuvent avoir un effet significatif sur la façon dont vos sites sont explorés.
Revenons un peu en arrière : Qu’est-ce que l’exploration ?
L’exploration est le processus qui consiste à découvrir de nouvelles pages Web, à revisiter les pages mises à jour et à les télécharger. En bref, Googlebot obtient une URL, effectue une requête HTTP vers le serveur qui l’héberge, puis traite la réponse de ce serveur, en suivant éventuellement des redirections, en gérant les erreurs et en transmettant le contenu de la page au système d’indexation de Google.
Mais les pages Web modernes ne se résument pas à du pur HTML, qu’en est-il alors des autres ressources qui composent une page ? Comment l’exploration de ces ressources affecte-t-elle le « budget d’exploration » ? Ces ressources sont-elles mises en cache du côté de Google ? Et y a-t-il une différence entre les URL qui n’ont jamais été explorées auparavant et celles qui sont déjà indexées ? Dans cet article, nous allons répondre à ces questions et bien plus encore !
Googlebot et l’exploration des ressources de page
Au-delà du HTML, les sites Web modernes utilisent une combinaison de différentes technologies telles que JavaScript et CSS pour offrir aux utilisateurs des expériences riches et des fonctionnalités utiles. Lors de l’accès à ces pages avec un navigateur, celui-ci télécharge d’abord l’URL parente qui héberge les données nécessaires pour commencer à construire la page pour l’utilisateur — le HTML de la page. Ces données initiales peuvent contenir des références à des ressources telles que JavaScript et CSS, mais aussi des images et des vidéos que le navigateur téléchargera à nouveau pour finalement construire la page finale qui est ensuite présentée à l’utilisateur.
Google fait exactement la même chose, bien que légèrement différemment :
- Googlebot télécharge les données initiales à partir de l’URL parente — le HTML de la page.
- Googlebot transmet les données récupérées au service de rendu Web (WRS).
- À l’aide de Googlebot, le WRS télécharge les ressources référencées dans les données d’origine.
- Le WRS construit la page en utilisant toutes les ressources téléchargées, tout comme le ferait le navigateur d’un utilisateur.
Comparé à un navigateur, le temps écoulé entre chaque étape peut être considérablement plus long en raison de contraintes de planification telles que la charge perçue du serveur hébergeant les ressources nécessaires au rendu d’une page. Et c’est là que
le budget d’exploration
entre en jeu.
L’exploration des ressources nécessaires au rendu d’une page entamera le budget d’exploration du nom d’hôte qui héberge la ressource. Pour y remédier, le WRS tente de mettre en cache chaque ressource (JavaScript et CSS) référencée dans les pages dont il fait le rendu. La durée de vie du cache du WRS n’est pas affectée par les directives de mise en cache HTTP ; à la place, le WRS met tout en cache jusqu’à 30 jours, ce qui contribue à préserver le budget d’exploration du site pour d’autres tâches d’exploration.
Du point de vue des propriétaires de sites, la gestion de la manière dont les ressources sont explorées et desquelles le sont peut influencer le budget d’exploration du site ; nous recommandons :
- Utilisez le moins de ressources possible pour offrir aux utilisateurs une excellente expérience ; moins il y a de ressources nécessaires pour le rendu d’une page, moins le budget d’exploration est dépensé lors du rendu.
- Utilisez les paramètres de contournement du cache avec prudence: si les URL des ressources changent, Google peut avoir besoin de les explorer à nouveau, même si leur contenu n’a pas changé. Cela consommera, bien entendu, du budget d’exploration.
- Hégez les ressources sur un nom d’hôte différent de celui du site principal, par exemple en utilisant un CDN ou simplement en hébergeant les ressources sur un sous-domaine différent. Cela transférera les préoccupations relatives au budget d’exploration vers l’hôte qui dessert les ressources.
Tous ces points s’appliquent également aux ressources multimédias. Si Googlebot (ou plus spécifiquement,
Googlebot-Image et Googlebot-Video respectivement) les récupère, cela consommera le budget d’exploration du site.
Il est tentant d’ajouter robots.txt à la liste également, mais du point de vue du rendu, interdire l’exploration des ressources pose généralement des problèmes. Si le WRS ne peut pas récupérer une ressource critique pour le rendu, la Recherche Google peut avoir du mal à extraire le contenu de la page et à permettre à cette dernière d’être positionnée dans la Recherche.
Qu’est-ce que l’exploration par Googlebot ?
La meilleure source pour analyser les ressources explorées par Google est constituée par les journaux d’accès bruts du site, qui contiennent une entrée pour chaque URL demandée par les navigateurs et les robots d’exploration. Pour identifier les robots de Google dans le journal d’accès, nous publions nos
plages d’adresses IP dans notre documentation pour développeurs.
La deuxième meilleure source est, bien entendu,
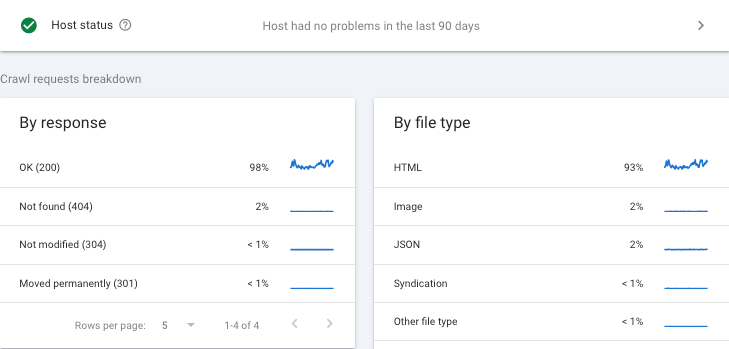
le rapport sur les statistiques d’exploration de la Search Console, qui ventile chaque type de ressource par robot d’exploration :
Enfin, si vous vous intéressez vraiment à l’exploration et au rendu et que vous souhaitez en discuter avec d’autres,
la communauté Search Central est l’endroit idéal, mais vous pouvez également nous trouver sur
LinkedIn.
Mises à jour
- Mise à jour du 6 décembre 2024: Impact notable sur les performances lors de la diffusion de ressources à partir d’une origine différente.
Vous souhaitez en savoir plus sur l’exploration ? Consultez l’ensemble de la série Crawling December :
Comment nous l'appliquons
Google announcements age. We keep this post here for the record, and we note for clients whether the behaviour it describes still applies today or has since been superseded.
Services associés